
Fehlende Daten? So füllst du Lücken zuverlässig und ohne Verzerrung

Fehlende Daten erkennen und passend behandeln: Imputation braucht begründete Annahmen.
Eine unbeantwortete Frage im Fragebogen, ein ausgefallener Messwert oder ein fehlender Eintrag in der Datenbank: Fehlende Daten gehören zum Alltag statistischer Auswertungen. Doch wie du mit diesen Lücken umgehst, kann deine Ergebnisse deutlich beeinflussen. Unvollständige Fälle einfach zu löschen oder fehlende Werte pauschal durch den Mittelwert zu ersetzen, kann Informationen kosten, Zusammenhänge verändern und die Unsicherheit deiner Ergebnisse unterschätzen.
Mit geeigneten Imputationsverfahren lassen sich fehlende Werte plausibel ergänzen. Entscheidend ist dabei, warum die Daten fehlen, welche Informationen zur Verfügung stehen und welches Ziel deine Analyse verfolgt. In diesem Artikel erfährst du, wie sich MCAR, MAR und MNAR unterscheiden, welche Verfahren zur Behandlung fehlender Werte geeignet sind und worauf du achten solltest, damit deine Auswertung möglichst belastbare Schlussfolgerungen ermöglicht.
Fehlende Daten? So füllst du Lücken zuverlässig und ohne Verzerrung
Im Alltag von Datenanalysten und Forschern tauchen sie immer wieder auf: leere Felder in Datensätzen, Fragen ohne Antwort, Messwerte, die fehlen. Was auf den ersten Blick banal wirkt, kann Auswertungen massiv verfälschen und Entscheider in die Irre führen. Studien zeigen, dass das Löschen unvollständiger Fälle hohe Informationsverluste verursacht und bei systematischem Ausfall sogar zu falschen Schlüssen führt.
Deshalb lohnt es sich, einen Plan für den Umgang mit Missing Data zu haben. Im folgenden Ratgeber erkläre ich dir, welche Imputationsverfahren es gibt, wann du welches Werkzeug einsetzen solltest und wie du typische Fallen vermeidest. Am Ende hast du konkrete Schritte, die du sofort anwenden kannst, um fehlende Werte plausibel zu ersetzen und die Aussagekraft deiner Analysen zu erhalten.
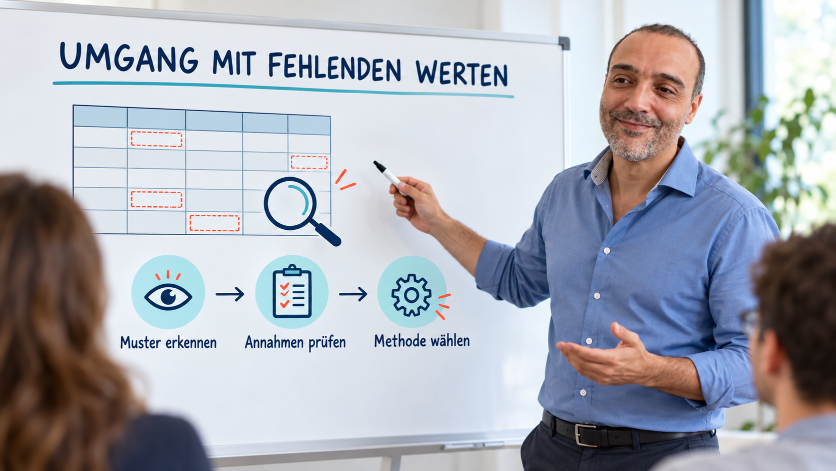
Fehlende Werte analysieren: Erst das Muster verstehen, dann die Methode wählen.
Wie kommen die fehlenden Werte zustande?
Entscheidend für den Umgang mit fehlenden Daten ist der Mechanismus des Fehlens: Bei MCAR (Missing Completely at Random) hängt das Fehlen weder mit beobachteten noch mit fehlenden Werten zusammen, etwa wenn Messdaten durch einen zufälligen technischen Ausfall verloren gehen. Bei MAR (Missing at Random) lässt sich die Wahrscheinlichkeit des Fehlens durch beobachtete Variablen erklären; beispielsweise kann die Teilnahme an einer Nachbefragung vom bereits erfassten Alter abhängen. Bei MNAR (Missing Not at Random) hängt das Fehlen auch nach Berücksichtigung beobachteter Informationen von den fehlenden Werten selbst ab, etwa wenn Personen mit besonders hohem Einkommen ihre Einkommensangabe häufiger verweigern. Multiple Imputation setzt in ihrer üblichen Anwendung MAR und ein geeignetes Imputationsmodell voraus. Bei MNAR sind zusätzliche Annahmen und Sensitivitätsanalysen erforderlich. MAR und MNAR lassen sich anhand der beobachteten Daten allein nicht sicher unterscheiden.
Was Imputation bringt und wann du sie brauchst
Wenn einzelne Werte in deiner Datenmatrix fehlen, hast du grundsätzlich drei Optionen: 1) Datensätze mit fehlenden Werten löschen, 2) fehlende Werte ignorieren bei bestimmten Analysen, oder 3) fehlende Werte durch Imputation ersetzen. Die erste Option ist einfach, birgt aber zwei große Risiken: Informationsverlust und Verzerrung der Stichprobe, wenn die Wahrscheinlichkeit des Fehlens mit dem Wert selbst zusammenhängt. Ein typisches Beispiel ist Einkommensbefragung, Personen mit hohem Einkommen melden sich öfter nicht, so dass ein vollständiger Datensatz tendenziell niedrigere Einkommen zeigt.
Imputation bedeutet, fehlende Werte durch plausible Schätzwerte zu ersetzen. Ziel ist nicht, die echten Werte perfekt zu rekonstruieren, sondern Verzerrungen zu vermeiden und Unsicherheit nachvollziehbar zu machen. Gute Imputation verbessert die Präzision deiner Schätzer und erlaubt die Nutzung kompletter Datensätze bei Standardmethoden wie Regressionen oder Mittelwertvergleichen.
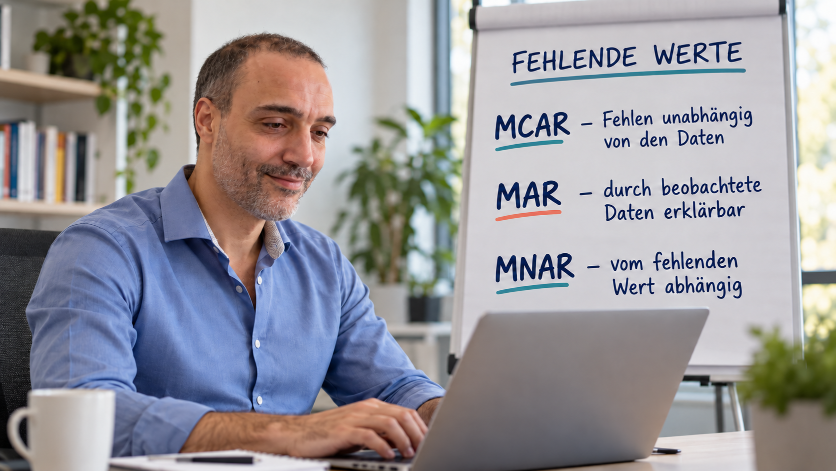
Aziz Wahbi bei der Missing Data Analysis
Wann solltest du imputieren?
- Wenn der Anteil fehlender Werte moderat bis hoch ist und Löschung zu starkem Informationsverlust führt.
- Wenn das Fehlen nicht komplett zufällig ist und mit beobachteten Variablen zusammenhängt.
- Wenn du Analysen durchführen willst, die vollständige Fälle benötigen, etwa viele multivariate Verfahren.
Praktische Imputationsverfahren und wie du sie anwendest
Imputation lässt sich grob in singuläre und multiple Verfahren teilen. Singuläre Imputation ersetzt jeden fehlenden Wert durch einen einzigen Schätzwert. Multiple Imputation erzeugt mehrere plausible Werte und bildet daraus die Schätzung plus Unsicherheitsabschätzung.
1) Einfache Substitution: Lagemaße
Die simpelste Methode ist, fehlende Werte durch den Mittelwert, Median oder Modus zu ersetzen. Vorteil: schnell und leicht verständlich. Nachteil: unterschätzte Streuung, mögliche Verzerrung, wenn das Fehlen systematisch ist.
Praktischer Tipp: Berechne Lagemaße innerhalb homogener Klassen (z. B. Altergruppen oder Regionen) statt über die ganze Stichprobe. Das reduziert Verzerrungen, weil imputierte Werte besser zur Gruppe passen.
2) Substitution durch Verhältnisschätzer
Wenn zwischen zwei Variablen X und Y ein stabiler funktionaler Zusammenhang besteht und X vollständig vorliegt, kannst du fehlende Y-Werte durch einen einfachen Verhältnisfaktor schätzen: Schätze den durchschnittlichen Quotienten von Y zu X aus den beobachteten Fällen und multipliziere ihn mit dem fehlenden X-Wert. Diese Methode ist nur sinnvoll bei starker Korrelation und sinnvoll skalierten Variablen.
3) Hot-Deck und Cold-Deck Verfahren
Bei Deck-Techniken ersetzt du fehlende Werte durch tatsächlich beobachtete Ausprägungen desselben Merkmals. Cold-Deck nutzt historische oder externe Datensätze, Hot-Deck wählt Beobachtungen aus derselben aktuellen Datenmatrix aus.
Ein verbreitetes Vorgehen ist das sequentielle Hot-Deck: Du legst Startwerte fest (z. B. Klassenmittel oder Zufallswerte), gehst Zeile für Zeile durch die Matrix, und ersetzt fehlende Werte jeweils durch aktuelle, innerhalb der Klasse verfügbare Werte. So fügst du realistische Werte ein, die Verteilungen und Zusammenhänge besser erhalten als bei starrer Mittelwert-Imputation.
4) Regressionsbasierte Imputation
Nutze Regressionsmodelle, wenn Beziehungen zwischen Variablen existieren. Bei quantitativen Zielgrößen bietet sich lineare Regression an: Schätze die Regressionskoeffizienten aus den vollständigen Fällen und sag anhand der beobachteten Prädiktoren die fehlenden Werte voraus. Bei kategorialen Zielvariablen sind logistische Regressionen oder andere spezifische Modelle angebracht.
Wichtig: Regressionsimputation kann die Varianz unterschätzen, weil sie Determinismus in die Daten bringt. Eine Abhilfe ist das Hinzufügen einer zufälligen Residualkomponente, sodass imputierte Werte nicht exakt auf der Regressionslinie liegen.
5) Multiple Imputation - das robusteste Verfahren
Multiple Imputation liefert für jeden fehlenden Wert mehrere plausible Werte, indem sie aus einer angenommenen multivariaten Verteilung simuliert. Du erhältst mehrere vollständig ausgefüllte Datensätze, führst deine Analyse in jedem Datensatz durch und kombinierst die Ergebnisse. So werden sowohl Schätzung als auch Unsicherheit korrekt abgebildet.
Multiple Imputation eignet sich, wenn fehlende Werte verbreitet sind und die Annahme eines Verteilungsmodells (z. B. multivariate Normalverteilung) plausibel ist. Die Methode ist in Statistiksoftware gut implementiert und empfiehlt sich für seriöse Forschungsanalysen.
Annahmen prüfen, Ergebnisse vergleichen und den Umgang mit fehlenden Werten offenlegen.
| Verfahren | Vorteil | Nachteil |
|---|---|---|
| Lagemaße | Schnell, einfach | Unterschätzt Streuung, verzerrt |
| Verhältnisschätzer | Nutzt funktionale Beziehung | Nur bei starker Korrelation gut |
| Hot-Deck / Cold-Deck | Realistische Werte, simpel umzusetzen | Auswahl der Donoren kann schwierig sein |
| Regressionsimputation | Nutzt mehrere Prädiktoren | Kann Varianz unterschätzen |
| Multiple Imputation | Schätzt Unsicherheit mit | Rechenintensiv, modellabhängig |
Fazit
Die wichtigste Erkenntnis ist: Löschen ist selten die beste Option. Wähle die Imputationsmethode nach dem Muster des Fehlens, dem Umfang der fehlenden Werte und dem Ziel deiner Analyse. Für explorative Zwecke reichen einfache Methoden, für belastbare Schlussfolgerungen ist multiple Imputation meist vorzuziehen.
Probier das heute selbst aus: Erzeuge zwei Versionen deines Datensatzes, eine mit einfacher Imputation, eine mit multipler Imputation, und vergleiche die Resultate. Beobachte insbesondere, wie sich Standardfehler und Signifikanz verändern.
Was passiert, wenn ich einfach Fälle mit fehlenden Werten lösche?
Das führt zu Informationsverlust und kann zu verzerrten Ergebnissen führen, wenn das Fehlen nicht komplett zufällig ist.
Wann reicht eine einfache Mittelwert-Imputation aus?
Für schnelle Explorationsanalysen mit sehr wenigen fehlenden Werten kann sie genügen, aber sie unterschätzt die Varianz und ist für finale Inferenz ungeeignet.
Brauche ich spezielle Software für multiple Imputation?
Ja, die meisten Statistikpakete wie R, SPSS oder Stata bieten Funktionen für multiple Imputation an, die den Prozess automatisieren.
Wie erkenne ich, ob das Fehlen zufällig ist oder nicht?
Analysiere Zusammenhänge zwischen fehlendemness-Indikatoren und beobachteten Variablen; systematische Muster deuten auf nicht zufälliges Fehlen hin.