Latente Profilanalyse oder Clusteranalyse? So wählst du die richtige Methode

Latente Profilanalyse oder Clusteranalyse? Unterschiede & passende Methoden im Vergleich.
Stell dir vor, du wertest eine Umfrage unter 500 Beschäftigten aus. Manche sind stark belastet und trotzdem zufrieden, andere kaum belastet und trotzdem unzufrieden. Mit einem einfachen Mittelwertvergleich oder einer Korrelation verschwinden genau diese Unterschiede im Durchschnitt. Dabei steckt in ihnen oft die eigentliche Geschichte deiner Daten.
Genau hier setzen zwei Verfahren an: die latente Profilanalyse (LPA) und die Clusteranalyse. Beide fassen Personen anhand ihrer Merkmalsmuster zu Gruppen zusammen, doch sie tun das auf unterschiedliche Weise. Dieser Artikel zeigt dir die wichtigsten Unterschiede, hilft dir bei der Methodenwahl und warnt dich vor typischen Fehlern.
Die beiden Verfahren verstehen
Was die latente Profilanalyse leistet
Die LPA ist ein modellbasierter Ansatz aus der Familie der latenten Mischungsmodelle. Sie wird vor allem bei mehreren kontinuierlichen Indikatorvariablen eingesetzt. Die Grundidee: Deine Stichprobe besteht möglicherweise aus Teilgruppen, die man nicht direkt sieht. Das Modell beschreibt deine Daten als Mischung mehrerer gruppenspezifischer Verteilungen.
Ein Beispiel mit den Variablen emotionale Erschöpfung, Arbeitszufriedenheit, Stress und soziale Unterstützung. Denkbar wären drei Profile:
- Gering belastet: niedrige Erschöpfung, wenig Stress, hohe Zufriedenheit.
- Stark belastet: hohe Erschöpfung, hoher Stress, niedrige Zufriedenheit.
- Belastet, aber unterstützt: erhöhter Stress bei hoher sozialer Unterstützung.
Das sind hypothetische Profile. Ob es sie wirklich gibt, zeigen erst deine Daten.
Zuordnung mit Wahrscheinlichkeiten
Die LPA ordnet Personen nicht stur per Distanzregel zu. Sie schätzt, mit welcher Wahrscheinlichkeit jemand zu jedem Profil gehört:
| Latentes Profil | Zugehörigkeitswahrscheinlichkeit |
|---|---|
| Profil 1 | 0,82 |
| Profil 2 | 0,13 |
| Profil 3 | 0,05 |
Hier ist die Sache klar: Profil 1. Bei Werten wie 0,45, 0,40 und 0,15 dagegen wird es knifflig. Die LPA macht diese Unsicherheit sichtbar. Das ist einer ihrer größten Vorteile.
Was die Clusteranalyse leistet
Die Clusteranalyse gruppiert Beobachtungen nach Ähnlichkeit. Sie braucht nicht zwingend ein Wahrscheinlichkeitsmodell, sondern ein Distanzmaß und einen Algorithmus. Zwei Klassiker:
- K-Means: Du gibst die Clusterzahl vor, und der Algorithmus minimiert die quadrierten Abstände zu den Clusterzentren.
- Hierarchische Verfahren: Einzelne Beobachtungen werden schrittweise zu größeren Gruppen verschmolzen, darstellbar im Dendrogramm.
Daneben gibt es dichtebasierte Verfahren wie DBSCAN und modellbasierte Clusterverfahren. Letztere sind der LPA methodisch sehr ähnlich.
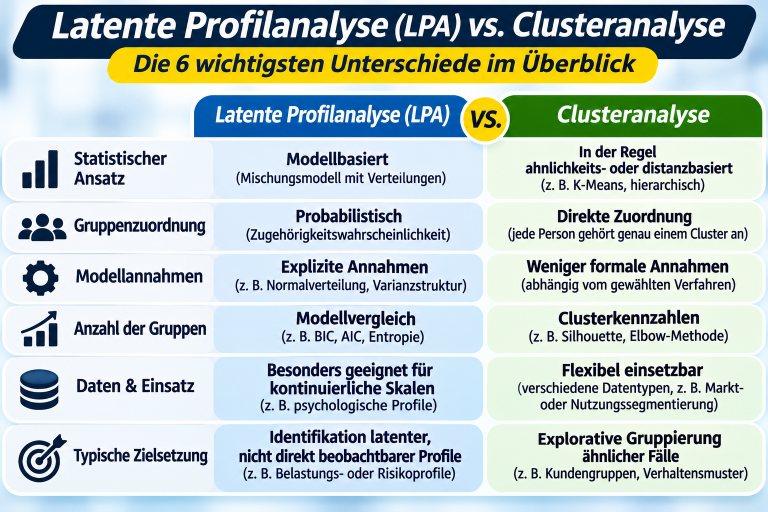
Latente Profilanalyse vs. Clusteranalyse: Die sechs wichtigsten Unterschiede im Überblick.
Der direkte Vergleich
| Kriterium | Latente Profilanalyse | Klassische Clusteranalyse |
|---|---|---|
| Ansatz | Modellbasiert | Meist distanzbasiert |
| Zuordnung | Wahrscheinlichkeiten | Meist direkt |
| Unsicherheit | Quantifizierbar | Nicht automatisch |
| Modellbewertung | AIC, BIC, Klassifikationsdiagnostik | Silhouette, Stabilitätsanalysen |
| Typische Anwendung | Psychologische und klinische Profile | Segmentierung, Exploration |
Die richtige Methode wählen und sauber arbeiten
Wann die LPA passt
- Latente Gruppen sind theoretisch plausibel. Etwa bei Motivation, Stresserleben und Bewältigungsstrategien.
- Die Zuordnungsunsicherheit zählt. Besonders bei überlappenden Profilen.
- Du willst Modelle systematisch vergleichen. Zum Beispiel Lösungen mit zwei bis fünf Profilen.
- Du willst die Profile mit anderen Variablen verknüpfen. Etwa mit späteren Beschwerden, mithilfe von Drei-Schritt-Verfahren.
Wann die Clusteranalyse reicht
- Explorative Analysen: Du willst erst einmal sehen, ob Gruppenstrukturen existieren, etwa bei Marktsegmentierung.
- Große Datensätze: K-Means ist bei numerischen Variablen und kompakten, annähernd kugelförmigen Clustern effizient.
- Keine Verteilungsannahmen gewünscht: Voraussetzungsfrei ist die Methode trotzdem nicht. Distanzmaß und Skalierung beeinflussen das Ergebnis stark.
- Pragmatische Segmentierung: Wichtig ist, dass die Gruppen stabil, interpretierbar und nützlich sind.
| Forschungsfrage | Möglicher Ansatz |
|---|---|
| Welche Belastungsprofile gibt es? | Latente Profilanalyse |
| Welche Kundengruppen kaufen ähnlich? | Clusteranalyse |
| Wie sicher ist die Gruppenzugehörigkeit? | Latente Profilanalyse |
| Welche Muster zeigen kategoriale Antworten? | Latente Klassenanalyse |
Die Zuordnungen sind keine starren Regeln. Auch modellbasierte Cluster eignen sich für Segmentierungen, und klassische Cluster können in der Psychologie sinnvoll sein.
Die Gruppenzahl bestimmen
Eine universelle Kennzahl gibt es nicht. Kombiniere deshalb mehrere Kriterien.
- AIC und BIC: Niedrigere Werte sind besser. Das BIC bestraft zusätzliche Parameter anders und wird bei der LPA oft bevorzugt.
- Entropie: Sie zeigt die Klassifikationssicherheit, ist aber kein Kriterium für die optimale Profilzahl.
- Likelihood-Ratio-Tests: Etwa der Bootstrap-Test, je nach Software.
- Interpretierbarkeit: Sind Profile kaum unterscheidbar, winzig oder instabil, taugt die komplexere Lösung nicht.
- Bei Clustern: Elbow-Methode, Silhouettenkoeffizient und Stabilitätsanalysen.
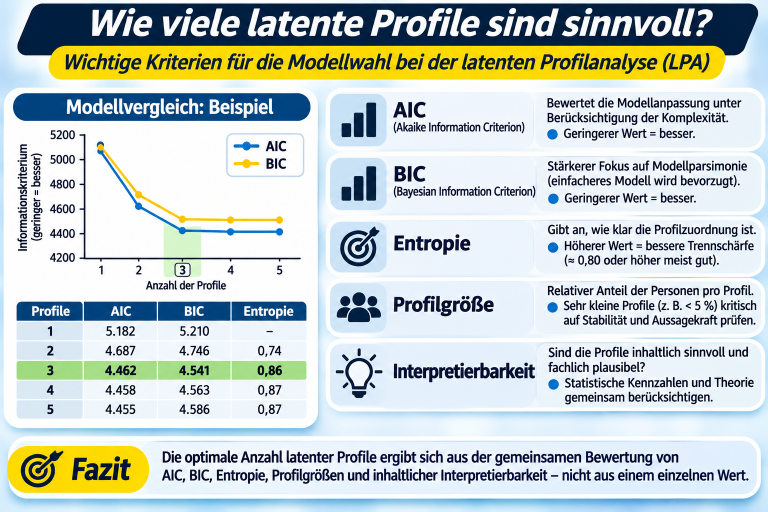
Latente Profilanalyse: AIC, BIC, Entropie und Profilgrößen für die Modellwahl bewerten.
Skalierung nicht vergessen
Misst du Alter in Jahren, Einkommen in Euro und Zufriedenheit auf einer Skala von 1 bis 5, dominiert bei euklidischen Distanzen das Einkommen. Standardisiere deshalb vor distanzbasierten Clusteranalysen. Bei der LPA hängt es vom Modell ab. Die Standardisierung erleichtert die Interpretation, kann aber bei bestimmten Restriktionen die Lösung beeinflussen. Prüfe also bewusst, statt automatisch zu standardisieren.
Fragebogendaten, LPA und LCA
Bei Fragebögen nutzt du für die LPA meist aggregierte Skalenwerte, die du näherungsweise als kontinuierlich behandelst. Prüfe vorher Reliabilität und faktorielle Struktur. Eine saubere Fragebogen Auswertung beginnt schon bei der Datenaufbereitung. Einzelne ordinale Likert-Items oder Ja-Nein-Antworten verlangen dagegen oft eine latente Klassenanalyse (LCA) mit kategorialen Indikatoren. Die Faustregel: LPA für kontinuierliche, LCA für kategoriale Indikatoren.
Voraussetzungen und Stichprobe
In einfachen LPA-Modellen gilt lokale Unabhängigkeit: Die Indikatoren sind innerhalb der Profile unkorreliert. Das ist aber nur eine häufige Restriktion, es gibt auch Modelle mit Kovarianzen. Ob Varianzen gleichgesetzt oder profilspezifisch geschätzt werden, verändert die Lösung erheblich. Schiefe Verteilungen und Ausreißer können zusätzliche Scheinprofile erzeugen. Mehr Profile bedeuten also nicht automatisch mehr echte Gruppen.
Eine feste Mindeststichprobe gibt es nicht. Sie hängt von der Zahl der Indikatoren und Profile, der Trennschärfe, den Profilgrößen und den Restriktionen ab. 200 Personen können bei einem einfachen Modell reichen, bei stark überlappenden Profilen reichen auch viel mehr nicht. Simulationen helfen bei der Planung.
Profile mit anderen Variablen vergleichen
Ordnest du jede Person ihrem wahrscheinlichsten Profil zu und vergleichst dann Gruppen, behandelst du die Zuordnung als fehlerfrei. Das verzerrt Effekte und Tests. Besser sind Drei-Schritt-Ansätze, die die Klassifikationsunsicherheit berücksichtigen. Welche Variante passt, hängt davon ab, ob die externe Variable Prädiktor oder Ergebnis ist.
Welche Software?
- R: Pakete für Gaußsche Mischungsmodelle und spezialisierte LPA-Workflows.
- Mplus: Weit verbreitet für latente Klassen- und Profilanalysen.
- Stata: Über Finite-Mixture- oder GSEM-Ansätze, mit sorgfältiger Spezifikation.
- SPSS: Bietet klassische Clusterverfahren, aber keine vollständige LPA.
Typische Fehler vermeiden
Auch Namen wie "resilient" oder "risikobehaftet" brauchen eine Grundlage in den tatsächlichen Indikatormustern und in der Theorie.
Ergebnisse sauber berichten
Dokumentiere die Modellspezifikation (Verteilung, Varianz-Kovarianz-Struktur, Schätzmethode), den Modellvergleich (getestete Profilzahlen, AIC, BIC), die Klassifikationsqualität (Entropie, mittlere posteriori Wahrscheinlichkeiten) und die Profilgrößen. Bei unklarer Gruppenzahl oder widersprüchlichen Modellen lohnt sich Hilfe bei der statistischen Auswertung.
Fazit
LPA und Clusteranalyse verfolgen dasselbe Ziel, aber mit unterschiedlichen Mitteln. Die LPA liefert ein statistisches Modell samt Zuordnungsunsicherheit. Die Clusteranalyse punktet bei Exploration und pragmatischer Segmentierung. Wähle nach Forschungsfrage und Datenlage, vergleiche mehrere Lösungen und prüfe sie immer auch inhaltlich. Probier es aus: Schätze bei deinem nächsten Datensatz mehrere Modelle und frage dich bei jeder Lösung, ob die Profile wirklich Sinn ergeben.
Ist die latente Profilanalyse besser als die Clusteranalyse?
Nein, nicht grundsätzlich. Die LPA ist stark, wenn du Modellvergleiche und Zuordnungsunsicherheit brauchst. Für explorative oder pragmatische Segmentierungen kann eine Clusteranalyse völlig ausreichen.
Wie viele Personen brauche ich für eine LPA?
Eine allgemeingültige Mindestgröße gibt es nicht. Entscheidend sind Zahl der Indikatoren und Profile, Trennschärfe und Profilgrößen. Simulationen helfen bei der Planung.
Reicht eine hohe Entropie, um die Profilzahl zu bestimmen?
Nein. Die Entropie zeigt nur, wie klar die Klassifikation ist. Für die Profilzahl brauchst du zusätzlich AIC, BIC, Tests und fachliche Plausibilität.
Was ist der Unterschied zwischen LPA und LCA?
Die LPA arbeitet meist mit kontinuierlichen Indikatoren, die LCA mit kategorialen. Beide gehören zu den latenten Mischungsmodellen.
Kann ich eine LPA in SPSS rechnen?
Die klassischen SPSS-Clusterprozeduren bieten keine vollständige LPA. Dafür nutzt man meist R, Mplus oder Stata.