Lineare Regression in R: Modellwahl, Annahmen und Ergebnisbericht Schritt für Schritt

Schreibtisch mit Laptop und Materialien für reproduzierbare Regressionsanalyse
Eine Regression in R zu rechnen, wirkt zunächst simpel: ein Befehl, ein Output, ein Signifikanzwert. Für eine Thesis, Dissertation oder Fachpublikation reicht das nicht. Das Modell muss zur Forschungsfrage passen, die Daten müssen sorgfältig aufbereitet sein, und die Ergebnisse brauchen eine fachlich saubere Darstellung.
R bietet dabei einen klaren Vorteil: Jeder Schritt ist dokumentierbar und reproduzierbar. Das setzt voraus, dass du verstehst, was dein Modell schätzt und welche Voraussetzungen gelten.
Von der Forschungsfrage zum passenden Modell
Eine lineare Regression eignet sich, wenn du prüfen willst, ob eine oder mehrere unabhängige Variablen eine metrische abhängige Variable erklären oder vorhersagen. Ein Beispiel aus der Psychologie: Sagen Stress, Schlafdauer und Alter den Depressionsscore voraus?
Die erklärenden Variablen heißen Prädiktoren. Mit einem Prädiktor spricht man von einer einfachen, mit mehreren von einer multiplen Regression. Entscheidend ist nicht ihre Anzahl: Jeder Prädiktor sollte sich aus deiner Hypothese, dem Studiendesign oder einer fachlich begründeten Kontrollstrategie ableiten.
Ist die abhängige Variable dichotom, etwa Therapieerfolg ja oder nein, brauchst du meist eine logistische Regression. Für Zähldaten, ordinale Skalen oder Messwiederholungen gelten wieder andere Annahmen. Die wichtigste Entscheidung fällt also vor der ersten Zeile Code.
Tablet mit Scatterplot, farblich markierten Ordnern und Lupe zur Datenprüfung
Daten sichten und Variablen vorbereiten
Verschaffe dir vor der Schätzung einen Überblick: str() und summary() zeigen Struktur und Verteilungen, colSums(is.na(daten)) zählt fehlende Werte je Variable.
Achte auf kategoriale Merkmale wie Geschlecht oder Behandlungsarm, die R als Zeichenkette eingelesen hat. Sie sollten als Faktor vorliegen, erzeugt mit factor(). Über levels legst du die Referenz fest: Steht „Kontrolle“ zuerst, beschreibt der Koeffizient für „Intervention“ den Unterschied zur Kontrollgruppe bei konstanten übrigen Prädiktoren.
Fehlende Werte solltest du nicht automatisch löschen. Bei wenigen, zufällig fehlenden Werten kann eine vollständige Fallanalyse vertretbar sein. Fehlen Daten systematisch oder umfangreich, droht eine verzerrte Stichprobe; dann sind eine begründete Imputation oder methodische Beratung meist sinnvoller.
Das Modell schätzen und den Output lesen
Geschätzt wird das Modell mit lm(): Links der Tilde steht die abhängige Variable, rechts stehen die Prädiktoren. summary() liefert die wichtigsten Kennwerte:
- Estimate: Richtung und Größe eines Effekts. Ein positiver Wert für Stress heißt: Der vorhergesagte Depressionsscore steigt mit dem Stress, wenn Schlafdauer und Alter konstant bleiben.
- Signifikanzwert p: zeigt, ob die Daten gegen die Nullhypothese sprechen, dass der Koeffizient null ist.
- Konfidenzintervall: über confint() abrufbar, gibt den Bereich plausibler Effektgrößen an.
- R²: Anteil der Varianz der abhängigen Variable, den das Modell erklärt.
Ein hohes R² ist kein Gütesiegel: Bei kleinen Stichproben oder vielen Prädiktoren fällt es leicht zu optimistisch aus. Berichte bei multiplen Modellen daher auch das korrigierte R².
Modellannahmen ernst nehmen
Nicht jede kleine Abweichung von den Annahmen entwertet ein Modell, du solltest Auffälligkeiten aber einordnen können. plot() erzeugt die zentralen Diagnosegrafiken, par(mfrow = c(2, 2)) ordnet sie gemeinsam an.
Residuen und Varianzhomogenität
Residuen sind die Abweichungen zwischen beobachteten und vorhergesagten Werten. Trägst du sie gegen die vorhergesagten Werte ab, sollte eine zufällige Punktwolke entstehen; deutliche Kurven sprechen für einen nichtlinearen Zusammenhang. Der QQ Plot zeigt, ob die Residuen annähernd normalverteilt sind, was vor allem bei kleinen Stichproben für die Inferenz zählt.
Besonders wichtig ist die Varianzhomogenität. Nimmt die Streuung der Residuen mit den vorhergesagten Werten deutlich zu oder ab, liegt Heteroskedastizität vor, und Standardfehler sowie Signifikanzwerte können täuschen. Je nach Fragestellung helfen Transformationen, heteroskedastizitätskonsistente Standardfehler oder ein anderes Modell.
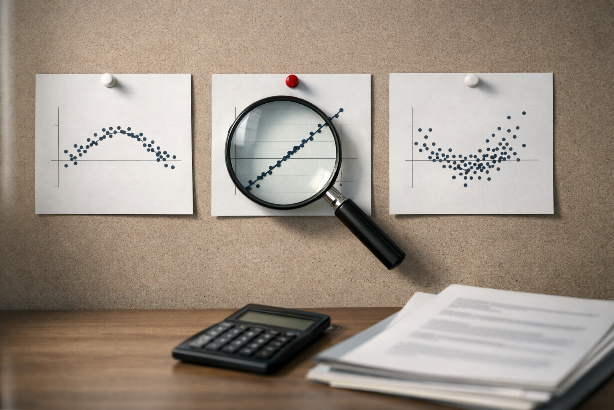
Diagnoseplots an Pinnwand mit Lupe, Taschenrechner und unscharfem Bericht zur Modellprüfung
Einflussreiche Fälle
Ein einzelner Fall kann die Regressionsgerade stark verschieben, ohne fehlerhaft zu sein. Prüfe zuerst Eingabefehler, Messbesonderheiten und fachliche Plausibilität. Fälle zu entfernen, nur weil sie das gewünschte Ergebnis stören, ist methodisch nicht vertretbar.
Multikollinearität erkennen
Hängen Prädiktoren sehr eng zusammen, etwa verwandte Skalenwerte oder klinische Kennwerte, lassen sich ihre Einzeleffekte kaum trennen. Man spricht dann von Multikollinearität. Warnsignale sind große Standardfehler, unerwartete Vorzeichen oder Effekte, die sich beim Hinzufügen einer Variable stark verändern.
Der Variance Inflation Factor (VIF), berechnet mit vif() aus dem Paket car, hilft bei der Prüfung. Werte ab 5 gelten grob als auffällig, ab 10 meist als deutlich problematisch, wobei diese Grenzen keine starre Regel sind. Als Lösung kannst du redundante Variablen nicht gemeinsam aufnehmen, einen theoretisch begründeten Summenscore bilden oder separate Modelle transparent gegenüberstellen.
Ergebnisse korrekt berichten
Ein signifikanter Koeffizient ist noch keine Interpretation. Berichte Effektgröße, Unsicherheit, Modellgüte und inhaltliche Bedeutung. Das Ergebnis b = 0,42, 95 % Konfidenzintervall [0,15; 0,69], p = 0,004 bedeutet: Eine Einheit mehr Stress geht mit einem um 0,42 Punkte höheren vorhergesagten Depressionsscore einher, unter Kontrolle der übrigen Variablen. Hinweise zur Darstellung solcher Werte im Ergebniskapitel bietet ein Ratgeber zu Statistik und Datenanalyse.
Vermeide kausale Aussagen wie „Stress verursacht Depression“, wenn deine Daten aus einer Querschnittserhebung stammen. Eine Regression kontrolliert nur beobachtete Variablen und ersetzt kein experimentelles Design.
Reproduzierbar arbeiten
Halte Datenaufbereitung, Analyse und Grafiken in einem Skript fest und dokumentiere Entscheidungen zu Ausreißern, fehlenden Werten, Kodierungen und Modellvarianten. Sind Skalenniveau oder Voraussetzungen unklar, lohnt sich eine methodische Klärung vor der finalen Auswertung.
Fazit
Eine belastbare Regression entsteht durch nachvollziehbare Entscheidungen, nicht durch möglichst langen Code. Wer Modellwahl, Datenaufbereitung, Annahmenprüfung und Ergebnisbericht sauber begründet, macht R zu einem verlässlichen Werkzeug für die eigene Forschung.