Multiples Testen entschlüsselt: So vermeidest du Alpha-Kumulierung

Wer viele Hypothesen prüft, muss Zufallstreffer bei p-Werten mitdenken.
Du untersuchst zunächst eine klar formulierte Hypothese. Dann kommen weitere Variablen, Untergruppen und Messzeitpunkte hinzu und plötzlich liegen zahlreiche p-Werte vor. Unter den auffälligen Ergebnissen kann auch ein Zufallstreffer sein, selbst wenn jeder einzelne Test korrekt durchgeführt wurde.
Entscheidend ist deshalb, welche Tests zu einer gemeinsamen Fragestellung gehören und welche Analysen du erst beim Erkunden der Daten ergänzt hast. In diesem Artikel zeige ich dir, warum diese Unterscheidung wichtig ist und wann Verfahren zur Korrektur für multiples Testen sinnvoll sind.
Multiples Testen entschlüsselt: So vermeidest du Alpha-Kumulierung
Viele denken, ein einzelner p-Wert bei 0,05 ist sicher. Das stimmt nur, wenn du genau einen Test machst. Sobald du mehrere Tests simultan durchführst, steigt das Risiko, fälschlich positive Ergebnisse zu erhalten. Die sogenannte Alphafehler-Kumulierung.
Dieses Problem taucht in vielen Alltagsfällen auf: Bei mehreren Gruppenvergleichen, in Genomstudien oder wenn verschiedene Endpunkte geprüft werden. In diesem Ratgeber lernst du die wichtigsten Konzepte, FWER, FDR, lokale und globale Signifikanzen, und bekommst konkrete Werkzeuge an die Hand, mit denen du falsche Entdeckungen kontrollierst und trotzdem echte Effekte findest.
Was ist multiples Testen und welche Begriffe solltest du kennen
Multiples Testen heißt schlicht: Du führst mehrere statistische Tests gleichzeitig durch. Das führt zu neuen Fehlerbegriffen, die du kennen musst, um Ergebnisse richtig zu interpretieren und Fehlalarme zu vermeiden.
Multipler Fehler 1. Art und FWER
Wenn bei mindestens einem Einzeltest eine Nullhypothese fälschlich abgelehnt wird, spricht man von einem multiplen Fehler 1. Art. Die Familie-weite Fehlerwahrscheinlichkeit (FWER) ist die Wahrscheinlichkeit, dass genau dieses Ereignis eintritt. Kontrollierst du die FWER streng, stellst du sicher, dass die Chance auf mindestens einen Fehlalarm unter einem vorgegebenen Niveau bleibt.
Lokales, globales und multiples Signifikanzniveau
- Lokales Signifikanzniveau: Jeder Einzeltest wird mit demselben Alpha durchgeführt. Das schützt jede Hypothese einzeln, verhindert aber nicht die Kumulierung über viele Tests.
- Globales Signifikanzniveau: Die Wahrscheinlichkeit eines Fehlers wird nur dann beschränkt, wenn alle Nullhypothesen gleichzeitig wahr sind, man testet eine Durchschnitts- oder Globalhypothese.
- Multiples Signifikanzniveau: Die stärkste Forderung die FWER muss für alle möglichen Parameterwerte kontrolliert werden, nicht nur für den Spezialfall, dass alle Nullhypothesen gelten.
Ein praktisches Beispiel: Bei Alpha = 0,05 und 20 unabhängigen Tests erreicht die grobe obere Schranke k*alpha bereits den Wert 1, das heißt die einfache lokale Kontrolle ist unbrauchbar. Das ist der Grund, warum Korrekturen nötig sind.
FDR - erwartete Fehlerquote der Ablehnungen
Statt die Wahrscheinlichkeit eines mindestens einen Fehlers zu begrenzen, kannst du auch den erwarteten Anteil falscher Ablehnungen unter allen Ablehnungen kontrollieren - die false discovery rate (FDR). FDR-orientierte Verfahren sind oft weniger konservativ und eignen sich, wenn du viele Hypothesen testest und bereit bist, eine kontrollierte Rate an Fehlentdeckungen zu akzeptieren.
Praktische Verfahren, wann welches verwenden und wie anwenden
Es gibt einfache, robuste und raffinierte Verfahren. Welche du wählst, hängt davon ab, ob du streng gegen Fehlalarme vorgehen willst (FWER-Kontrolle) oder lieber mehr Entdeckungen zulässt und die Fehlerquote kontrollierst (FDR-Kontrolle).
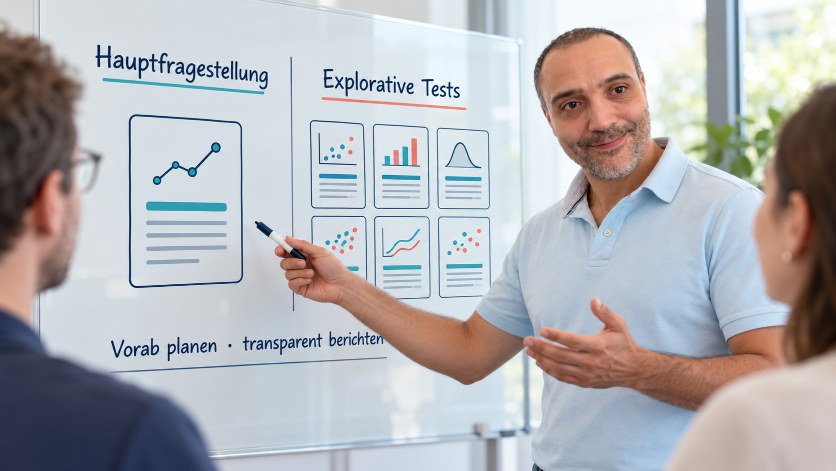
Hauptfrage und explorative Tests trennen: Das erleichtert die Einordnung der Ergebnisse.
Übersicht wichtiger Verfahren
| Verfahren | Ziel | Voraussetzung | Charakter |
|---|---|---|---|
| Bonferroni | Kontrolle der FWER | keine | sehr konservativ, einfach anzuwenden |
| Šidák | Kontrolle der FWER | Unabhängigkeit der Tests | weniger konservativ als Bonferroni bei Unabhängigkeit |
| Holm (Bonferroni-Holm) | Kontrolle der FWER, schrittweise | keine strenge Voraussetzung | mäßig konservativ, leistungsfähiger als einfache Bonferroni |
| Benjamini-Hochberg (BH) | Kontrolle der FDR | Unabhängige p-Werte oder bestimmte Abhängigkeiten | erlaubt mehr Entdeckungen, gut für viele Tests |
| Benjamini-Yekutieli | Kontrolle der FDR unter Abhängigkeit | positive Abhängigkeitsstruktur | konservativer als BH, aber sicherer bei Abhängigkeit |
Wann welches Verfahren wählen
- Du brauchst strenge Kontrolle über jeden Fehlalarm: Nutze Bonferroni oder Holm. Holm ist oft besser, weil es schrittweise weniger konservativ vorgeht.
- Tests sind unabhängig und du willst mehr Power: Šidák ist eine Option.
- Du testest Hunderte oder Tausende Hypothesen (z. B. -omics, Screening): Benjamini-Hochberg ist meist die bessere Wahl, weil die FDR-Kontrolle mehr Entdeckungen zulässt und reale Funde wahrscheinlicher macht.
Konkrete Schritte zur Umsetzung
- Definiere vorab, welches Fehlerkriterium du kontrollieren willst - FWER oder FDR. Das beeinflusst Methodenauswahl und Interpretation.
- Berechne alle p-Werte sauber und dokumentiere Testanzahl k und Abhängigkeiten zwischen Tests.
- Wähle eine Korrektur: Bonferroni/Šidák/Holm für FWER, BH/BY für FDR.
- Bei FWER: passe die lokalen Signifikanzniveaus an (z. B. alpha/k für Bonferroni). Bei FDR: ordne p-Werte und wende die BH-Regel an.
- Interpretiere Befunde transparent - gib korrigierte p-Werte oder Schwellen an und unterscheide bestätigte von explorativen Ergebnissen.
Do's & Don'ts
- Do: Plane die Tests vorab und begründe die Hypothesenfamilie. - Do: Nutze Holm statt einfacher Bonferroni, wenn du mehr Power willst. - Do: Bei großen Multiplen Tests erwäge FDR-Kontrolle und anschließende Validierung.
- Don't: Verwende nicht ungefragt das lokale Alpha für viele Tests - das führt zu erhöhter Fehlerrate. - Don't: Vermeide selektives Berichtwesen von nur signifikanten Ergebnissen ohne Korrektur.
Kurzes Beispiel aus der Praxis
Wenn du drei Mittelwerte vergleichst und insgesamt 3 paarweise Tests durchführst, reicht oft Holm, weil er kohärent ist und Konsonanz wahrt. Bei 1.000 Genvarianten ist Bonferroni meist zu streng, hier ist BH zielführender.
Fazit
Die wichtigste Erkenntnis: Mehr Tests bedeuten mehr Risiko für falsche Positivbefunde. Entscheide dich vorher, ob du die Wahrscheinlichkeit wenigstens eines Fehlers (FWER) oder den erwarteten Anteil falscher Entdeckungen (FDR) kontrollieren willst, und wähle das passende Verfahren (Bonferroni/Holm/Šidák für FWER, Benjamini-Hochberg für FDR). Dokumentiere dein Vorgehen und validiere wichtige Resultate zusätzlich.
Probier heute folgendes aus: Formuliere deine Hypothesenfamilie, zähle die Tests und wende für einen kleinen Demo-Datensatz Holm und BH an, so bekommst du ein Gefühl für die Unterschiede.
Muss ich immer korrigieren, wenn ich mehrere Tests mache?
Nicht zwingend, aber grundsätzlich solltest du die Anzahl der Tests und das gewünschte Fehlerkriterium berücksichtigen; ohne Korrektur steigt das Risiko für Fehlalarme deutlich.
Wann ist Benjamini-Hochberg besser als Bonferroni?
BH ist besser, wenn du viele Tests durchführst und bereit bist, eine kontrollierte Rate falscher Entdeckungen zu akzeptieren, um mehr echte Signale zu finden.
Was ist die einfachste Methode, um FWER zu kontrollieren?
Die Bonferroni-Korrektur ist die einfachste Methode: Verwende alpha/k als lokales Signifikanzniveau für jeden Test.
Kann ich mehrere Verfahren kombinieren?
Ja, du kannst explorative Analysen mit FDR durchführen und anschließende Bestätigungsanalysen mit FWER-kontrollierenden Methoden oder unabhängigen Daten.
Was tun bei abhängigen Tests?
Bei Abhängigkeiten sind Šidák und BH nicht immer geeignet; Benjamini-Yekutieli oder schrittweise FWER-Verfahren wie Holm sind robustere Alternativen.