Statistik in der Tiermedizin: So planst und wertest du Studien belastbar aus

Forschungsarbeitsplatz mit Laptop, Tiermodellen und Probenröhrchen
Ob Befunde aus der Kleintierpraxis, Laborwerte aus einer Interventionsstudie oder Überlebenszeiten in der Nutztierhaltung: Viele tiermedizinische Datensätze wirken zunächst übersichtlich. Ob daraus eine tragfähige Aussage entsteht, entscheidet jedoch die statistische Auswertung. Studiendesign, Datenstruktur und Forschungsfrage müssen zusammenpassen, lange bevor Ergebnisse in eine Dissertation, Abschlussarbeit oder Publikation einfließen.
Statistik ist in der Tiermedizin daher kein bloßer Rechenschritt am Schluss. Verschiedene Tierarten, kleine Stichproben, wiederholte Messungen, Praxisdaten und ethische Grenzen bei der Rekrutierung machen die Methodik anspruchsvoll. Wenn du diese Punkte früh berücksichtigst, vermeidest du Korrekturschleifen, Fehlschlüsse und unnötige Rückfragen von Betreuenden oder Gutachtenden.
Was tiermedizinische Daten besonders macht
In tiermedizinischen Studien treffen klinischer Alltag und geringe Fallzahlen oft aufeinander. Bei seltenen Erkrankungen stehen nur wenige Tiere zur Verfügung. Gleichzeitig gibt es pro Tier häufig mehrere Messungen, etwa Blutwerte vor, während und nach einer Therapie. Diese Werte hängen voneinander ab. Behandelst du sie als unabhängige Beobachtungen, werden p Werte verzerrt und die Wirksamkeit erscheint womöglich größer, als sie ist.
Hinzu kommt eine hierarchische, also verschachtelte Struktur: Tiere stammen aus Beständen, Praxen oder Kliniken mit unterschiedlicher Haltung und Behandlungsroutine. Ob ein einfacher Gruppenvergleich genügt oder ein gemischtes Modell nötig ist, hängt nicht von der Software ab, sondern von der Forschungsfrage und der Entstehung der Daten. Gemischte Modelle berücksichtigen über sogenannte zufällige Effekte, dass sich Tiere derselben Einheit ähnlicher sind. Einen vertiefenden Einstieg bietet der Ratgeber zur longitudinalen Datenanalyse.
Auch der Endpunkt, also die zentrale Zielgröße, prägt die Methodenwahl. Geht es um einen stetigen Laborwert, ein klinisches Ansprechen mit ja oder nein oder die Zeit bis zu einem Ereignis? Diagnostische Studien nutzen zusätzlich Sensitivität, Spezifität, prädiktive Werte und ROC Kurven. Epidemiologische Projekte betrachten Prävalenzen, Risikofaktoren und Störgrößen (Confounder). Das Ziel ist ein begründetes Analysekonzept statt möglichst vieler Einzeltests.
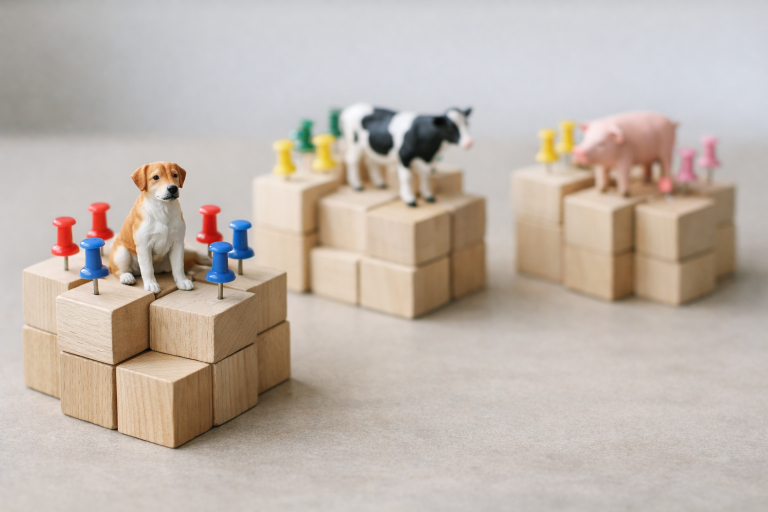
Holzklötze mit Tierfiguren in Gruppen, farbige Stecknadeln als Messwiederholungen
Planung beginnt vor der Datenerhebung
Ein schwaches Studiendesign lässt sich durch keine Auswertung vollständig ausgleichen. Methodische Unterstützung lohnt sich deshalb schon in der Planung. Eine präzise Forschungsfrage legt fest, welche Zielvariable zählt, welche Gruppen verglichen werden und welche Einflussgrößen zu kontrollieren sind.
Zentral ist die Fallzahlplanung. Zu kleine Stichproben übersehen echte Effekte. Zu große binden unnötig Ressourcen und sind ethisch schwer zu rechtfertigen. Du brauchst dafür Annahmen zu Effektgröße, Streuung, Signifikanzniveau und Teststärke (Power, die Chance, einen vorhandenen Effekt zu erkennen). Diese Annahmen sollten sich auf Vorstudien oder klinische Relevanz stützen, nicht auf pauschale Standardwerte.
Bei rückblickenden Krankenaktenstudien ist die Fallzahl meist vorgegeben. Trotzdem lohnt eine Prüfung: Reichen die Ereignisse für eine logistische Regression? Wie viele Kovariaten (erklärende Variablen) verträgt das Modell? Unterscheiden sich eingeschlossene und ausgeschlossene Fälle systematisch? Davon hängt ab, wie weit du Ergebnisse interpretieren kannst.
Datenqualität vor der Analyse sichern
Viele Probleme zeigen sich schon beim ersten Blick in die Rohdaten: uneinheitliche Kodierungen, doppelt vergebene Tiernummern, fehlende Einheiten oder unplausible Werte. Eine sorgfältige Datenprüfung ist daher fester Bestandteil jeder seriösen Auswertung.
Besondere Aufmerksamkeit verdienen fehlende Werte. Fehlen Laborwerte zufällig oder vor allem bei schwer erkrankten Tieren? Davon hängt ab, ob eine Analyse nur der vollständigen Fälle vertretbar ist. Ausreißer solltest du nicht vorschnell löschen; sie können Eingabefehler, aber auch klinisch relevante Extremfälle sein. Dokumentiere zudem jeden Ausschluss von Fällen, jede Transformation von Variablen sowie die Festlegung primärer und sekundärer Endpunkte.
Das Verfahren folgt der Fragestellung
Zwei Gruppen bedeuten nicht automatisch einen t Test. Zuerst ist zu klären, ob die Daten annähernd normalverteilt sind, ob die Varianzen vergleichbar sind und ob die Beobachtungen unabhängig sind. Bei kleinen Stichproben können robuste oder nichtparametrische Verfahren sinnvoll sein. Grundsätzlich besser sind sie nicht, denn sie beantworten teils andere Fragen und liefern andere Effektmaße.
Für wiederholte Messungen sind lineare oder generalisierte gemischte Modelle meist flexibler als viele Einzeltests. Sie erfassen Unterschiede zwischen einzelnen Tieren und können unter bestimmten Voraussetzungen auch lückenhafte Messreihen einbeziehen. Bei Überlebensdaten eignen sich Kurven nach Kaplan und Meier sowie die Regression nach Cox, weil sie Zensierung berücksichtigen, also Fälle ohne beobachtetes Ereignis bis Studienende. Entscheidend ist, dass das Modell zu Datenmenge, Messniveau und Fragestellung passt und sich im Methodenteil verständlich begründen lässt.
Nahaufnahme einer Prüfliste, Lupe auf unscharfem Datenausdruck und Probenröhrchen
Ergebnisse verständlich berichten
Ein signifikantes Ergebnis ist noch keine Interpretation. Effektgröße, Konfidenzintervall (der Bereich, in dem der wahre Wert plausibel liegt) und klinische Relevanz wiegen mindestens so schwer wie der p Wert. Hilfreich sind folgende Grundsätze:
- Tabellen zeigen, wie viele Tiere analysiert wurden und in welcher Einheit Werte vorliegen.
- Bei kleinen Stichproben sind Einzelwerte und Verteilungen oft aussagekräftiger als Balkendiagramme.
- Regressionsmodelle werden mit Effektmaßen und Konfidenzintervallen berichtet, nicht nur mit p Werten.
- Rückblickende Daten belegen meist Zusammenhänge, aber keine Kausalität; kleine Fallzahlen verlangen vorsichtige Formulierungen.
Wann externe Beratung sinnvoll ist
Unterstützung lohnt sich besonders bei anspruchsvollen Methoden oder knapper Zeit. Das gilt etwa für multivariable Modelle, Längsschnittdaten, diagnostische Gütestudien, Überlebenszeitanalysen, Ethikanträge oder Kommentare von Gutachtenden. Gute Beratung ist keine Blackbox: Sie erklärt Verfahren und geprüfte Voraussetzungen, damit du deine Arbeit selbst vertreten kannst. Lege Forschungsfrage, Studienprotokoll, Datensatz, Variablenbeschreibungen und Abgabetermin am besten früh bereit.
Fazit
Kleine Fallzahlen, wiederholte Messungen und verschachtelte Strukturen machen tiermedizinische Statistik anspruchsvoll. Wer Design, Datenqualität, Methode und Reporting früh aufeinander abstimmt, kann Ergebnisse sicher begründen. Auch nach der Datenerhebung ist eine strukturierte Planung noch möglich.