Statistikfehler kurz vor der Abgabe: Was du noch retten kannst

Statistikfehler & kurz vor Abgabe? Vieles lässt sich noch korrigieren.
Die Bachelorarbeit ist fast fertig, die Masterarbeit muss in wenigen Tagen raus, die Dissertation steht kurz vor der Einreichung. Auswertungen, Tabellen und Grafiken sind erledigt, der Ergebnisteil ist geschrieben. Dann kommt der Moment, in dem sich plötzlich Fragen melden: War das wirklich der richtige Test? Warum unterscheiden sich die Fallzahlen? Und was, wenn eine zentrale Variable falsch kodiert wurde?
Die gute Nachricht vorweg: Nicht jeder statistische Fehler bedeutet, dass du alles neu schreiben musst. Viele Probleme lassen sich auch spät noch beheben. Andere verlangen eine Neuauswertung, und manche lassen sich nur noch offen als Grenze der Arbeit benennen. In diesem Ratgeber erfährst du, wie du schnell einschätzt, in welcher Lage du steckst, und welche Schritte dir jetzt am meisten helfen.
Erst prüfen, dann handeln
Bei Zweifeln ist die Versuchung groß, hektisch Zahlen anzupassen oder wild alternative Tests auszuprobieren. Genau das macht die Lage oft schlimmer. Klär zuerst, welches Problem wirklich vorliegt. Grundsätzlich fallen Statistikprobleme in drei Kategorien.
Die drei Fehlerkategorien
- Darstellungs- und Berichtsfehler: Die Berechnung stimmt, aber die Darstellung nicht. Typisch sind vertauschte Tabellenbeschriftungen, fehlende Konfidenzintervalle oder ein falsch interpretierter p-Wert. Das lässt sich meist schnell beheben.
- Fehler in der Durchführung: Eine Variable wurde falsch kodiert, ein ungeeigneter Test gewählt oder die Abhängigkeit wiederholter Messungen ignoriert. Einzelne Analysen oder ganze Teile müssen dann wiederholt werden.
- Grundlegende methodische Probleme: Der Fehler steckt im Studiendesign oder in der Datenerhebung, etwa eine fehlende Kontrollgruppe. Nachträglich ist das statistisch oft nicht mehr zu korrigieren.
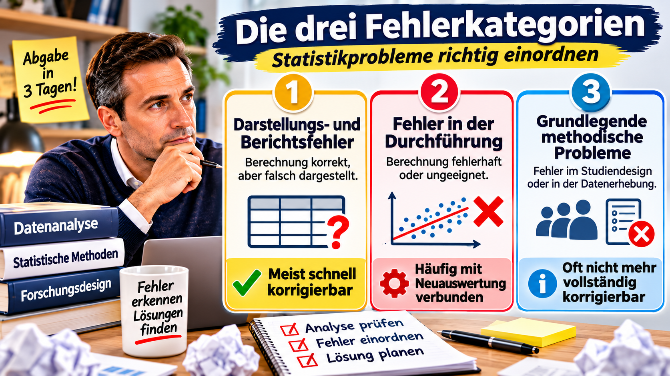
Drei Kategorien von Statistikfehlern: Was lässt sich korrigieren und wo liegen die Grenzen?
Falscher Test: Meist korrigierbar
Stell dir vor, du vergleichst das Stressniveau von 60 Personen vor und nach einer Intervention. Wer hier einen t-Test für unabhängige Stichproben nutzt, ignoriert, dass es dieselben Personen sind. Passend wäre bei erfüllten Voraussetzungen der t-Test für verbundene Stichproben. Liegen die Rohdaten vor und lassen sich die Werte den Personen zuordnen, rechnest du einfach neu. Danach musst du allerdings Ergebnisse und womöglich Schlussfolgerungen anpassen.
Ähnlich ist es bei drei oder mehr Gruppen mit vielen paarweisen t-Tests. Hier kommen eine Varianzanalyse mit Post-hoc-Vergleichen oder Korrekturen für multiples Testen infrage. Wichtig: Wähle die Methode nie danach, welches Verfahren den schönsten p-Wert liefert.
Voraussetzungen nicht geprüft?
Eine verletzte Voraussetzung macht eine Analyse nicht automatisch unbrauchbar. Außerdem muss nicht jede Variable normalverteilt sein. Bei der linearen Regression geht es um die Residuen, beim gepaarten t-Test um die Verteilung der Differenzen. Oft kannst du Diagnostik nachholen, etwa Residuenplots, Ausreißerprüfung oder Varianzchecks. Bei Problemen helfen robuste Verfahren oder Sensitivitätsanalysen.
Unterschiedliche Fallzahlen
In der Deskription 120 Personen, bei der Korrelation 114, in der Regression 103? Das ist nicht automatisch ein Fehler. Eine Regression schließt Fälle aus, bei denen eine Modellvariable fehlt, eine Korrelation braucht weniger Variablen. Auch Ausschlusskriterien spielen mit hinein.
Kritisch wird es bei unbeabsichtigten Filtern. In SPSS kann ein aktiver Filter den Datensatz still verkleinern, in R reduzieren frühere Verarbeitungsschritte manchmal die Daten. Prüfe deshalb Ausgangsstichprobe, fehlende Werte und Filter und dokumentiere je Analyse, welche Fälle eingeflossen sind. Ist der Unterschied sachlich korrekt, genügt eine transparente Erläuterung. Bei unbeabsichtigtem Ausschluss rechnest du neu. Kommst du der Ursache nicht auf die Spur, kann eine Statistik-Hilfe die Filter und Variablen systematisch durchgehen.
Falsch kodierte Variablen
Bei einem Fragebogen zur Arbeitszufriedenheit sind manche Items positiv, andere negativ formuliert. Vergisst du das Umpolen vor der Skalenbildung, kippen Mittelwerte, Reliabilität, Korrelationen und Regressionen. Mit den Original-Antworten ist das reparierbar: korrekt kodieren, alles darauf Aufbauende neu rechnen und prüfen, welche Tabellen, Abbildungen und Textstellen betroffen sind. Ein einzelner Kodierfehler zieht sich oft durch viele Schritte. Kontrolliere deshalb auch fehlende Werte und Gruppencodes.
Fehlende Daten
Wer alle Fälle mit Lücken automatisch ausschließt (Complete-Case-Analyse), verliert Informationen und riskiert unter Umständen verzerrte Ergebnisse. Die multiple Imputation kann eine Alternative sein, ist aber keine Universallösung: Sie hängt vom Ausfallmechanismus, den verfügbaren Variablen und dem Imputationsmodell ab. Bleiben nur noch wenige Tage, ist eine komplette Neuaufbereitung oft zu groß. Dann benenne die Grenzen deiner Analyse transparent. Beliebige Ersatzwerte einzusetzen repariert nichts.
Nicht signifikant ist nicht falsch
Ein p-Wert über 0,05 ist kein Scheitern. Er beweist nicht, dass kein Effekt existiert, und ein signifikanter Wert beweist nicht, dass ein Effekt bedeutsam ist. Zieh Effektgrößen, Konfidenzintervalle und die Präzision der Schätzung heran.
Stattdessen lässt sich die Interpretation schärfen: Vielleicht ist der Effekt relevant, aber unsicher. Vielleicht ist die Stichprobe zu klein. Oder dein Ergebnis widerspricht der Hypothese und ist gerade deshalb interessant.
Regression und Ergebnisdarstellung
Bei auffälligen Koeffizienten oder großen Standardfehlern lohnt der Blick auf Multikollinearität sowie auf Residuen, Hebelwerte und Einflussdiagnostik. Ein hoher Zusammenhang zweier Prädiktoren heißt nicht, dass einer raus muss, und ein auffälliger Wert ist nicht zwingend falsch. Entscheide theoretisch begründet. Bei der logistischen Regression gilt: Exponentierte Koeffizienten sind Odds Ratios, keine relativen Risiken.
Auch ohne Neuberechnung gibt es viel zu tun:
- Achsen, Gruppen und Einheiten prüfen
- Tabellenwerte mit dem Output abgleichen
- sehr kleine p-Werte als p < 0,001 statt p = 0,000 angeben
- Effektgrößen wie Cohen's d, Korrelationen oder Odds Ratios ergänzen
- nach einer Neuauswertung auch den Text anpassen, nicht nur die Tabelle
Gerade bei der Bachelorarbeit hilft bei Unsicherheiten eine gezielte Statistik-Hilfe für die Bachelorarbeit.
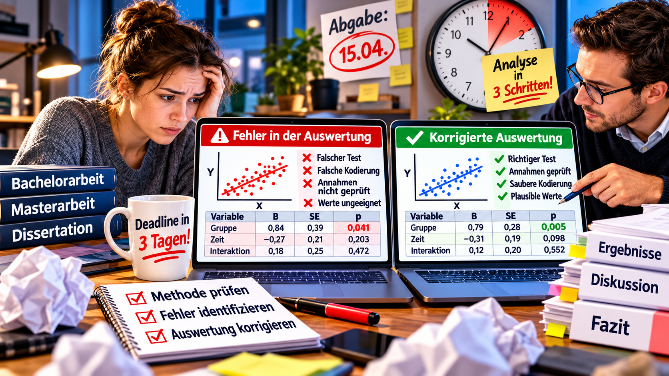
Kurz vor der Abgabe unsicher mit der Auswertung. Eine Statistik-Beratung kann helfen.
Was ist korrigierbar, was nicht, und wie gehst du vor?
Grenzen der Korrektur
Nicht alles lässt sich retten. Ohne geeignete Vergleichsgruppe sind belastbare kausale Aussagen kaum möglich, und eine nie erhobene Variable lässt sich nicht herbeirechnen. Auch umfangreiche Messfehler oder eine kleine Stichprobe bleiben bestehen, egal welcher Test folgt. Dann gilt: Benenne Grenzen offen, schwäche Schlussfolgerungen ab und ordne die Aussagekraft realistisch ein. Das überzeugt mehr, als Probleme zu verdecken.
Übersicht: Wie schnell lässt sich was beheben?
| Statistikproblem | Nachträglich korrigierbar? | Typischer Aufwand |
|---|---|---|
| Falsche Tabellenbeschriftung | Meist ja | Gering |
| p-Wert falsch interpretiert | Meist ja | Gering |
| Effektgrößen fehlen | Häufig ja | Gering bis mittel |
| Voraussetzungen nicht geprüft | Häufig ja | Gering bis hoch |
| Fallzahlen ungeklärt | Häufig ja | Gering bis mittel |
| Falscher statistischer Test | Oft ja | Mittel bis hoch |
| Variablen falsch kodiert | Mit Rohdaten häufig ja | Mittel bis hoch |
| Fehlende Werte ungeeignet behandelt | Teilweise | Mittel bis hoch |
| Wichtige Variablen nicht erhoben | Häufig nicht vollständig | Grundlegende Einschränkung |
| Ungeeignetes Studiendesign | Häufig nicht vollständig | Grundlegende Einschränkung |
Das ist keine verbindliche Zeitprognose. Liegen nur Screenshots des Outputs vor und der Datensatz fehlt, wird selbst eine einfache Korrektur aufwendig.
Dein Notfallplan für die letzten Tage
- Originaldateien sichern: Kopiere Datensatz, Skripte und aktuelle Arbeit.
- Problem präzise formulieren: Nicht „Meine Statistik ist falsch“, sondern etwa: „Ich habe drei Messzeitpunkte mit unabhängigen t-Tests verglichen, obwohl dieselben Personen untersucht wurden.“
- Auswirkungen prüfen: Eine falsch beschriftete Tabelle betrifft wenig, eine falsch berechnete Skala vieles.
- Kritisches zuerst: Fehler, die zentrale Ergebnisse oder die Gültigkeit betreffen, haben Vorrang vor Formatierung.
- Nachvollziehbar korrigieren: Dokumentiere Änderungen und passe Methodik, Tabellen und Diskussion an.
- Plausibilität prüfen: Stimmen Fallzahlen, Kennzahlen, Tabellen und Interpretationen überein, und beantwortet die Arbeit noch die Forschungsfragen?
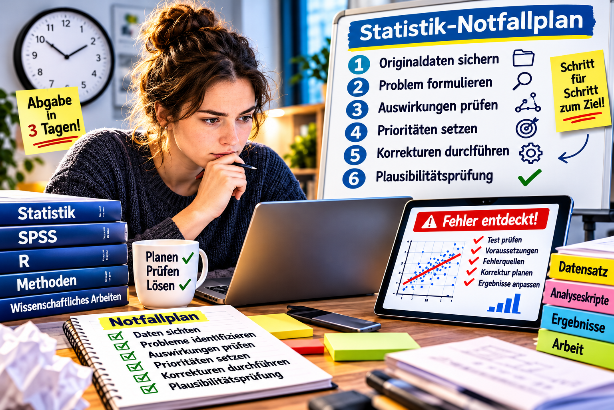
Statistik-Notfallplan: In sechs Schritten Fehler erkennen und vor der Abgabe korrigieren.
Wann sich Beratung lohnt
Kleine Berichtsfehler korrigierst du selbst. Holst du dir Unterstützung, dann vor allem, wenn:
- unklar ist, ob der Test geeignet ist,
- SPSS, R oder Stata unerwartete Ergebnisse liefern,
- Fallzahlen unerklärt bleiben,
- komplexe Modelle überprüft werden müssen,
- die Betreuung methodische Einwände hat.
Bei der Masterarbeit können sich Fehler über mehrere Hypothesen und Kapitel ziehen. Wer kurzfristig Hilfe bei der Statistik-Auswertung für die Masterarbeit braucht, stellt am besten früh Daten, Ergebnisse und konkrete Fragen zusammen. Bei medizinischen Dissertationen mit Überlebenszeitanalysen oder logistischen Modellen ist eine fachliche Prüfung vor jeder Änderung besonders wichtig. Hilfreich sind Datensatz, Skripte oder Outputdateien, Forschungsfragen, relevante Textabschnitte und Hinweise der Betreuung. Eine seriöse Beratung verspricht dabei keine bestimmten Ergebnisse, sondern eine methodisch korrekte Einschätzung.
Fazit: Realistisch einschätzen statt panisch rechnen
Statistikprobleme kurz vor der Abgabe sind unangenehm, aber selten das Ende. Falsch kodierte Variablen, ungeeignete Tests, unvollständige Berichte und fehlende Diagnostik lassen sich meist beheben, solange Daten und Analyseschritte nachvollziehbar sind. Bei Problemen im Design oder der Erhebung sind die Möglichkeiten begrenzt. Nicht jede Auffälligkeit ist ein Fehler, nicht jeder Fehler braucht eine komplette Neuauswertung.
Dein Takeaway: Sichere deine Dateien, benenne das Problem genau und arbeite dich nach Priorität durch. Fang heute mit dem Abgleich von Fallzahlen und Tabellen an.
Kann ich meine Auswertung kurz vor der Abgabe noch ändern?
Grundsätzlich ja. Festgestellte Fehler solltest du korrigieren und dabei alle betroffenen Tabellen, Texte und Schlussfolgerungen anpassen. Beachte außerdem die Vorgaben deiner Hochschule.
Was passiert, wenn ich den falschen Test verwendet habe?
Sind die Daten vorhanden, lässt sich meist ein geeignetes Verfahren nachträglich durchführen. Ergebnisse und Interpretation können sich dadurch allerdings verändern.
Muss ich die ganze Arbeit neu schreiben, wenn die Statistik falsch ist?
Nicht zwangsläufig. Bei einzelnen Berichtsfehlern genügen gezielte Änderungen, bei grundlegenden Analysefehlern können größere Überarbeitungen nötig werden.
Sind nicht signifikante Ergebnisse ein Problem?
Nein. Sie sind wissenschaftlich zulässig und können wichtige Erkenntnisse liefern. Entscheidend ist eine sachgerechte Interpretation mit Effektgrößen und statistischer Unsicherheit.
Kann ich fehlende Werte kurz vor der Abgabe noch imputieren?
Das kann möglich sein, erfordert aber eine methodische Prüfung. Multiple Imputation passt nicht zu jeder Datenlage und kann weitere Analysen sowie Anpassungen im Ergebnisteil nach sich ziehen.
Du brauchst Unterstützung? Ich helfe dir bei der Überprüfung statistischer Analysen, der Fehlersuche in SPSS, R oder Stata und der methodisch korrekten Interpretation. Zuerst wird das Problem eingegrenzt und geklärt, welche Korrekturen im Zeitrahmen realistisch sind. Gerade kurz vor der Abgabe zählt nicht, mehr zu rechnen, sondern die richtigen statistischen Entscheidungen zu treffen.