Strukturgleichungsmodell: Typische SEM-Fehler vermeiden und dein Modell richtig prüfen

Strukturgleichungsmodelle und CFA: Professionelle Hilfe mit AMOS, Stata und R.
Dein Modell läuft durch, die Software spuckt Zahlen aus - und trotzdem fühlt sich etwas falsch an? Der CFI sieht gut aus, der RMSEA nicht. Faktorladungen fallen niedriger aus als erwartet, oder die Berechnung konvergiert gar nicht erst. Genau an diesem Punkt scheitern viele Auswertungen mit Strukturgleichungsmodellen, und zwar selten an der Bedienung der Software.
Strukturgleichungsmodelle (SEM) und die konfirmatorische Faktorenanalyse (CFA) gehören zu den mächtigsten, aber auch anspruchsvollsten Verfahren der multivariaten Statistik. Sie sind in Psychologie, Sozialwissenschaften, Bildungsforschung, Gesundheitswissenschaft und empirischer Wirtschaftsforschung Standard. In diesem Artikel erfährst du, wie ein SEM aufgebaut ist, wo typische Stolperfallen lauern, wie du den Modell-Fit sinnvoll beurteilst und wann sich professionelle Unterstützung lohnt.
Grundlagen: So funktionieren SEM und CFA
Beobachtete und latente Variablen
Ein SEM verbindet mehrere Verfahren: Regressionen, Pfadanalysen, Mediationsmodelle, Mehrgruppenvergleiche oder latente Wachstumskurvenmodelle. Der Clou: Ein theoretisches Konstrukt muss nicht durch eine einzelne Variable abgebildet werden.
Beobachtete Variablen stehen direkt im Datensatz, etwa das Alter oder die Antwort auf eine Fragebogenaussage. Latente Variablen wie Arbeitszufriedenheit, Selbstwirksamkeit oder Lebensqualität erschließt du dagegen aus mehreren Indikatoren. Im reflektiven Messmodell nimmst du an, dass ein gemeinsames Konstrukt die Antworten beeinflusst. Der Rest der Varianz ist Messfehler, den das Modell explizit berücksichtigt. Ob ein Konstrukt überhaupt reflektiv modelliert werden darf, musst du theoretisch begründen.
Messmodell und Strukturmodell
Das Messmodell klärt: Werden deine Konstrukte durch die gewählten Indikatoren angemessen repräsentiert? Die Faktorladungen zeigen, wie eng Item und Faktor zusammenhängen.
Das Strukturmodell klärt: Welche Zusammenhänge bestehen zwischen den Konstrukten? Etwa ob Stress die Arbeitszufriedenheit vorhersagt und ob emotionale Erschöpfung diesen Effekt teilweise vermittelt.
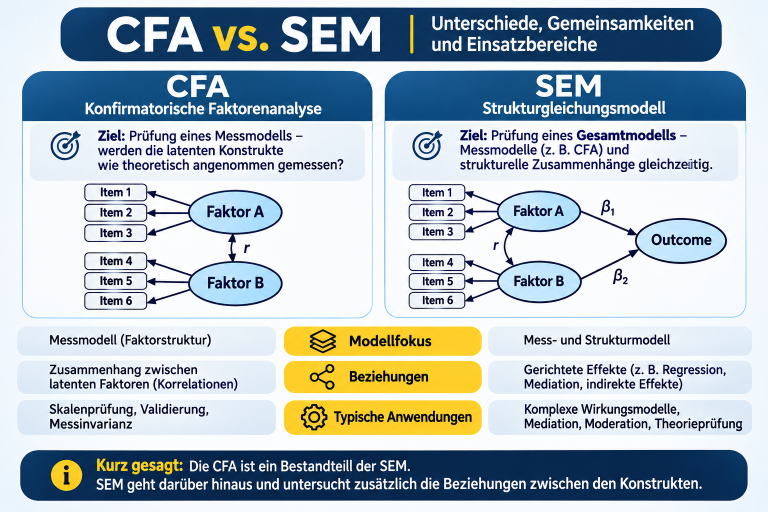
CFA vs. SEM: Unterschiede zwischen Messmodellen und komplexen Strukturgleichungsmodellen.
CFA oder EFA?
Bei der CFA legst du die Faktorstruktur vor der Schätzung fest. Sie prüft Hypothesen, statt Strukturen zu entdecken.
| Explorative Faktorenanalyse | Konfirmatorische Faktorenanalyse |
|---|---|
| Faktorstruktur wird exploriert | Faktorstruktur wird vorab spezifiziert |
| Zuordnungen zunächst weniger restriktiv | Ladungsstruktur gezielt festgelegt |
| Für unbekannte Strukturen | Für die Prüfung theoretischer Messmodelle |
| Fokus auf Strukturentdeckung | Fokus auf Modellprüfung |
Verwende die CFA nicht dazu, so lange herumzuprobieren, bis irgendeine Struktur passt. Wer viele Änderungen an denselben Daten vornimmt, arbeitet explorativ. Das ist erlaubt, wenn du es offenlegst und das Ergebnis idealerweise an unabhängigen Daten überprüfst.
Modellprüfung in der Praxis: Identifikation, Fit und Software
Wann Beratung sinnvoll ist
Hol dir Unterstützung, wenn eine dieser Situationen auf dich zutrifft:
- Die Modellstruktur ist unklar. Du hast Hypothesen, weißt aber nicht, welche Konstrukte latent sein sollen und welche Beziehungen du zulässt.
- Der Fit ist unzureichend. Parameter so lange freizugeben, bis Grenzwerte erreicht sind, ist keine Lösung. Du musst klären, was theoretisch und empirisch vertretbar ist.
- Das Modell ist nicht identifiziert. Die Parameter lassen sich nicht eindeutig bestimmen.
- Die Software warnt. Typisch sind Nichtkonvergenz, nicht positiv definite Kovarianzmatrizen, negative Residualvarianzen, extrem hohe Faktorkorrelationen oder instabile Standardfehler.
- Du schreibst eine Dissertation oder Publikation. Dann brauchst du eine nachvollziehbare Modellbeschreibung, Angaben zur Schätzung, Fit-Indizes und eine fachlich saubere Interpretation, oft ergänzt um Robustheitsanalysen oder Messinvarianz.
Identifikation: Rechnet die Software, heißt das noch nichts
Ein theoretisch sinnvolles Modell ist nicht automatisch identifiziert. Achte auf drei Dinge:
- Skalierung: Latente Variablen haben keine Maßeinheit. Fixiere eine Ladung auf 1 oder die Varianz des Faktors. Das beeinflusst die Interpretation unstandardisierter Parameter.
- Indikatorenzahl: Faktoren mit drei guten Indikatoren lassen sich in vielen Standardmodellen identifizieren. Bei ein oder zwei Indikatoren brauchst du oft zusätzliche Restriktionen. Entscheidend bleibt das Gesamtmodell.
- Freiheitsgrade: Positive Freiheitsgrade allein garantieren keine Identifikation. Auch Parameterstruktur und lokale Bedingungen zählen.
Den Modell-Fit richtig lesen
Betrachte nie einen Index isoliert. Jeder erfasst einen anderen Aspekt, deshalb sind widersprüchliche Werte nichts Ungewöhnliches.
| Kennwert | Aussage | Einschränkung |
|---|---|---|
| χ²-Test | Prüft exakte Modellanpassung | Abhängig von Stichprobengröße und Annahmen |
| CFI | Relative Anpassung gegenüber Referenzmodell | Abhängig vom Referenzmodell |
| TLI | Relative Anpassung mit Blick auf Komplexität | Kein universeller Grenzwert |
| RMSEA | Approximative Abweichung | Problematisch bei wenigen Freiheitsgraden |
| SRMR | Standardisierte Residualabweichungen | Allein nicht ausreichend |
Orientierungswerte wie CFI 0,90 oder 0,95, RMSEA unter 0,08 oder 0,06 und SRMR bis 0,08 sind keine Gesetze. Schau beim RMSEA zusätzlich auf das Konfidenzintervall. Prüfe außerdem, ob das Modell theoretisch Sinn ergibt, die Parameter plausibel sind und lokale Fehlanpassungen vorliegen.
Ladungen, Reliabilität und Validität
Niedrige Faktorladungen deuten auf Items mit geringem Messbeitrag hin. Streiche Items aber nicht blind nach einem starren Grenzwert, sondern bedenke ihre inhaltliche Bedeutung für das Konstrukt.
Bei der Reliabilität sind modellbasierte Maße oder Omega oft passender als Cronbachs Alpha, das auf bestimmten Annahmen beruht. Die AVE (häufig mit 0,50 als Orientierung) ergänzt die Prüfung der konvergenten Validität. Für die diskriminante Validität helfen Faktorkorrelationen, Modellvergleiche oder das HTMT-Kriterium. Validität lässt sich nie mit einer einzelnen Kennzahl belegen.
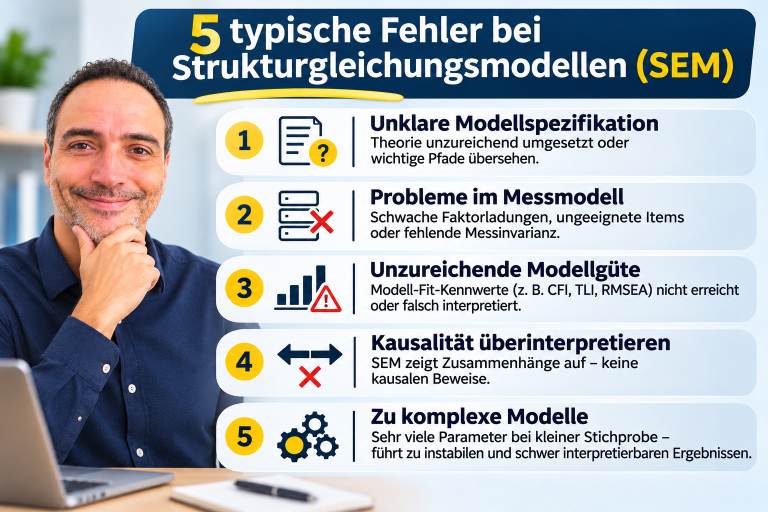
Fünf typische Fehler bei Strukturgleichungsmodellen: Ursachen erkennen und vermeiden.
AMOS, Stata oder R?
Eine beste Software für alle Modelle gibt es nicht. Entscheidend ist, ob sie dein Modell mit einem passenden Schätzverfahren unterstützt.
- IBM SPSS Amos: grafische Modellierung per Pfaddiagramm, ideal für den Einstieg. Die Gefahr: Modelle entstehen nach optischen Gesichtspunkten, und Fehlerterme werden freigegeben, nur um den Fit zu verbessern. Das ist nicht automatisch theoretisch gerechtfertigt.
- Stata: sem für klassische lineare Modelle, gsem für generalisierte Modelle. Do-Files machen alles reproduzierbar. Übertrage die globalen CFA-Fit-Indizes aber nicht ungeprüft auf GSEM-Modelle.
- R mit lavaan: skriptbasiert, flexibel, reproduzierbar.
Wenn du bereits ein Pfadmodell gebaut hast, aber bei Identifikation, Fit oder Interpretation unsicher bist, findest du gezielte AMOS-Hilfe für Strukturgleichungsmodelle oder professionelle Stata-Hilfe bei Mehr als Durchschnitt.
Stichprobe, fehlende Werte und Messinvarianz
Pauschale Regeln wie „mindestens 200 Fälle“ oder „zehn Personen pro Parameter“ reichen nicht. Der nötige Umfang hängt unter anderem von Zahl und Qualität der Indikatoren, Ladungsstärke, Modellkomplexität, Effektgrößen, Verteilung, fehlenden Werten und dem Schätzverfahren ab. Bei anspruchsvollen Projekten helfen Monte-Carlo-Simulationen: Du erzeugst wiederholt Datensätze unter plausiblen Annahmen und siehst, wie zuverlässig Parameter geschätzt werden und wie oft Konvergenzprobleme auftreten.
Bei fehlenden Werten prüfst du zuerst die plausiblen Ursachen. Ein kompletter Fallausschluss kann verzerren. Je nach Modell kommen FIML oder multiple Imputation infrage, aber keines davon ist eine Universallösung. Bei Verteilungsproblemen helfen robuste Schätzer. Robustes ML und WLSMV beruhen auf unterschiedlichen Annahmen und sind nicht beliebig austauschbar. Dokumentiere die Schätzmethode immer und begründe sie.
Willst du Gruppen oder Messzeitpunkte vergleichen, brauchst du Messinvarianz. Du prüfst sie stufenweise:
- Konfigural: Ist die Faktorstruktur vergleichbar?
- Metrisch: Sind die Faktorladungen gleichgesetzt?
- Skalar: Sind zusätzlich Intercepts (bei ordinalen Modellen Schwellen) gleich? Das ist wichtig für den Vergleich latenter Mittelwerte.
Als Orientierung wird oft eine CFI-Veränderung von höchstens 0,01 diskutiert, jedoch nicht unabhängig von Modelltyp und Stichprobe.
Fazit
Ein gutes Strukturgleichungsmodell entsteht nicht durch schöne Fit-Werte, sondern durch das Zusammenspiel von Theorie, Daten, Schätzverfahren und Interpretation. Nimm Warnmeldungen ernst, passe dein Modell nicht nur zahlenorientiert an und dokumentiere jede Entscheidung. Schau dir heute dein aktuelles Modell an und frag dich bei jeder Modifikation: Kann ich sie theoretisch begründen? Wenn nicht, ist das ein guter Moment, dir fachliche Unterstützung zu holen.
Reicht es, wenn CFI und RMSEA bestimmte Grenzwerte erreichen?
Nein. Die Grenzwerte sind nur Orientierung. Du solltest zusätzlich die theoretische Plausibilität, die Parameter und lokale Fehlanpassungen prüfen.
Warum konvergiert mein Modell nicht?
Mögliche Ursachen sind fehlende Identifikation, ungeeignete Restriktionen, unzureichende Skalierung, zu kleine Stichproben oder schwache Indikatoren. Die genaue Ursache musst du am konkreten Modell untersuchen.
Welche Software ist für SEM die beste?
Das hängt von Modell, Daten und Vorkenntnissen ab. AMOS überzeugt grafisch, Stata im größeren Analyse-Workflow, R mit lavaan durch Flexibilität und Reproduzierbarkeit.
Wie viele Fälle brauche ich für eine CFA?
Eine pauschale Zahl gibt es nicht. Der Umfang hängt von Ladungsstärke, Modellkomplexität, Schätzverfahren und fehlenden Werten ab. Bei komplexen Modellen helfen Simulationen.
Wann brauche ich Messinvarianz?
Immer dann, wenn du latente Konstrukte zwischen Gruppen oder über mehrere Messzeitpunkte vergleichen willst.