Warum Code allein nicht reicht: Daten, Syntax und Output sauber abgleichen

Leerer Archivraum mit Regalen und versiegeltem Datenträger in durchsichtiger Hülle
Du hältst eine fertig formatierte Ergebnistabelle und ein passendes Skript für deine Abschlussarbeit in den Händen. Auf den ersten Blick wirkt alles vollständig: Spaltenüberschriften, Mittelwerte mit zwei Nachkommastellen und die dazugehörigen Befehle liegen sauber geordnet vor. Trotzdem steht vor der Übernahme in dein Manuskript eine entscheidende Prüffrage im Raum: Belegt dieses Skript tatsächlich, dass die vorliegenden Zahlen genau aus deinen Untersuchungsdaten berechnet wurden?
In der wissenschaftlichen Praxis wird ein gespeicherter Programmcode häufig bereits als ausreichender Nachweis für eine erfolgte Berechnung angesehen. Doch ein Skript zeigt zunächst nur, welche Befehle formuliert wurden. Ob diese Befehle jemals mit deiner konkreten Datei ausgeführt wurden und genau jene Werte erzeugt haben, die später im Ergebnisteil stehen, lässt sich erst durch den systematischen Abgleich von Datenversion, Analyseweg und tatsächlicher Softwareausgabe klären.
Warum ein Skript allein noch keine Berechnung belegt
Ein Analyseweg in Form von gespeicherter Syntax ist ein wichtiger Baustein jeder nachvollziehbaren Auswertung, ersetzt aber nicht den Beleg der eigentlichen Ausführung. Ein Skript kann sprachlich und formal völlig fehlerfrei aussehen, ohne jemals in einer Statistiksoftware gelaufen zu sein. Ebenso kommt es im Arbeitsalltag regelmäßig vor, dass ein Skript zwar gestartet wurde, dabei jedoch auf einen älteren Dateistand verweist oder mit veränderten Grundeinstellungen arbeitet.
Wenn du lediglich eine fertige Tabelle im Textdokument und eine separate Codedatei nebeneinanderlegst, fehlt das verbindende Glied zwischen Rohdaten und Ergebnis. Ein tabellarisches Format im Manuskript ist immer nur eine Darstellungsentscheidung. Ob die berichteten Kennwerte deine Untersuchung zutreffend beschreiben, entscheidet sich nicht an der optischen Schlüssigkeit der Tabelle oder an der Eleganz des Codes. Belastbar wird eine Auswertung erst dann, wenn eindeutig dokumentiert ist, welche Datei eingelesen wurde, welche Variablen definiert wurden und welches konkrete Ergebnisprotokoll die Software bei genau diesem Durchlauf ausgegeben hat.
Makroaufnahme eines versiegelten antistatischen Beutels mit einem externen Datenträger
Die erste Prüfebene: Datenversion und Vorbereitung eindeutig zuordnen
Bevor du einzelne Rechenschritte im Code kontrollierst, solltest du prüfen, ob die verwendete Datenversion zweifelsfrei erkennbar ist. In vielen Projekten entstehen während der Datenbereinigung mehrere Dateistände. Werden Tippfehler korrigiert, Ausreißer entfernt oder unvollständige Fragebögen aussortiert, verändert sich die Fallzahl. Fehlt in deinen Unterlagen der eindeutige Hinweis darauf, welche exakte Datei als Grundlage diente, lässt sich eine Ergebnistabelle später nicht mehr sicher zuordnen.
Zur nachvollziehbaren Dokumentation gehören deshalb drei eng verbundene Angaben zur Datenbasis:
- Die genaue Bezeichnung und der Stand der eingelesenen Datendatei müssen im Protokoll oder im Skript sichtbar sein.
- Die Definition der ausgewerteten Variablen sowie eventuelle Umkodierungen oder Zusammenfassungen müssen festgehalten werden.
- Die Behandlung fehlender Werte und sämtliche Ausschlüsse einzelner Beobachtungen müssen vor der eigentlichen Testberechnung nachvollziehbar begründet und dokumentiert sein.
Stell dir als konstruiertes Gedankenspiel vor, deine Tabelle weist für zwei Gruppen eine bestimmte Anzahl an Beobachtungen aus, während deine gespeicherte Rohdatei deutlich mehr Zeilen umfasst. Ohne dokumentierte Ausschlussregeln und ohne Abgleich mit den tatsächlichen fehlenden Werten bleibt völlig offen, welche Fälle in die Berechnung eingeflossen sind und ob die Auswahl fachlich gerechtfertigt war.
Das Zusammenspiel aus Daten, Verfahren und echter Softwareausgabe
Erst wenn Datenstand und Vorbereitung geklärt sind, greift der eigentliche Dreiklang einer überprüfbaren Statistik: Der dokumentierte Datensatz, das ausgeführte Verfahren in der Syntax und die unmittelbare Ausgabe der Statistiksoftware müssen lückenlos zusammenpassen. In einer vollständigen Dokumentation siehst du im Auswertungsprotokoll nicht nur die Endergebnisse, sondern auch den zuvor ausgeführten Befehl, die eingelesene Fallzahl und die tatsächlich verwendeten Variablennamen.
Prüfe bei deinen Unterlagen gezielt, ob eine originale Softwareausgabe vorliegt oder ob lediglich eine bereits für den Fließtext aufbereitete Übersicht existiert. Ein echtes Auswertungsprotokoll zeigt dir, ob die im Skript formulierten Befehle tatsächlich abgearbeitet wurden. Zudem lassen sich dort wichtige Details ablesen, die in verkürzten Ergebnistabellen oft verschwinden: Wurden Fehlwerte versehentlich als gültige Zahlen behandelt? Wurden Gruppen richtig zugeordnet? Wurde bei wiederholten Messungen derselben Personen auch wirklich ein Verfahren für abhängige Beobachtungen gewählt statt eines Vergleichs unabhängiger Gruppen? Erst dieser direkte Abgleich von Daten, ausgeführtem Verfahren und Output macht deine Zahlen fachlich überprüfbar.
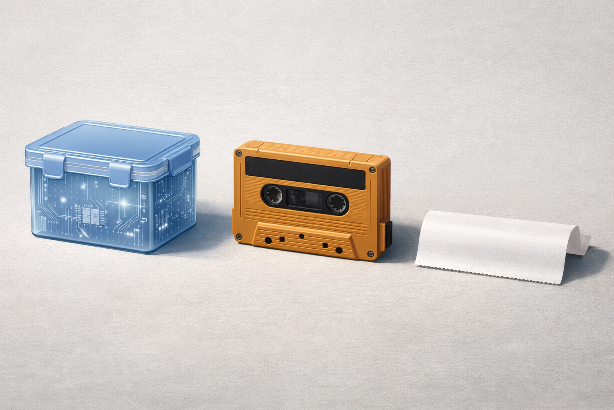
Editorial-Illustration mit drei farblich getrennten Objekten für Daten, Code und Ausgabe
Grenzen der Nachvollziehbarkeit und sachlicher Umgang mit Lücken
Selbst wenn du Daten, Skript und Softwareausgabe sorgfältig abgleichst, musst du bei einer erneuten Ausführung mit bestimmten technischen Besonderheiten rechnen. Abweichungen in der letzten Nachkommastelle oder leicht veränderte Kennwerte bedeuten nicht sofort, dass die ursprüngliche Auswertung fehlerhaft war. Bei einer Wiederholung müssen Rundungsregeln, spezifische Softwareeinstellungen der jeweiligen Programmversion und gegebenenfalls beteiligte Zufallsverfahren berücksichtigt werden.
Ebenso wichtig ist eine sachliche Einordnung, falls in deinen Unterlagen einzelne Bausteine fehlen. Fehlende Protokolle oder eine unklare Dateizuordnung beweisen nicht, dass Zahlen frei erfunden wurden. Sie begrenzen zunächst nur das, was sich zum aktuellen Zeitpunkt fachlich bestätigen lässt. Eine seriöse Prüfung trennt deshalb strikt zwischen nachweisbaren Fehlern im Rechenweg und reinen Dokumentationslücken, die durch das Nachreichen der Originalausgabe oder der richtigen Datenversion behoben werden können. Wenn du wissen möchtest, wie sich diese Dokumentationsprüfung in die gesamte Bewertung statistischer Ergebnisse einfügt, kannst du dazu im Statistikratgeber von Easy Statistik weiterlesen.
Fazit für deine eigene Auswertungsprüfung
Eine optisch stimmige Tabelle und ein separat gespeichertes Skript genügen für sich genommen noch nicht, um eine Berechnung zweifelsfrei zu belegen. Prüfe vor der Übernahme in deine Arbeit immer, ob die exakte Datenversion, der Umgang mit fehlenden Werten, das ausgeführte Skript und die originale Softwareausgabe vollständig vorliegen und inhaltlich übereinstimmen. So erkennst du frühzeitig, welche Ergebnisse bereits auf einem sicheren Fundament stehen und wo du vor der Abgabe noch fehlende Belege ergänzen solltest.