
Zeitreihenanalyse von Finanzdaten: so modellierst du Renditen und Volatilität

Dr. Stankov hat seinen PhD in Corporate Finance an der TU Darmstadt erlangt
Ein Kursdiagramm suggeriert Klarheit: steigt die Linie, scheint der Trend offensichtlich, und die Versuchung ist groß, daraus eine Prognose abzuleiten. Für eine wissenschaftliche Arbeit genügt dieser optische Eindruck nicht. Entscheidend ist, ob sich die zeitliche Struktur der Daten statistisch belegen lässt und ob die Annahmen des gewählten Modells zur Datenlage passen.
Dieser Beitrag begleitet dich durch ein typisches Analysebeispiel mit täglichen Kursdaten eines Aktienindex: von der Datenprüfung über die Berechnung der Renditen bis zur Modellierung von Mittelwert und Varianz. Ziel ist kein möglichst komplexes Verfahren, sondern eine Analyse, in der jede Entscheidung fachlich begründet ist.
Forschungsfrage und Datenbasis klären
Angenommen, eine Masterarbeit im Bereich Finance fragt, ob sich tägliche Renditen eines Aktienindex kurzfristig vorhersagen lassen und ob Phasen starker Schwankungen statistisch nachweisbar sind. Eine präzise Forschungsfrage benennt Zielgröße, Datenfrequenz und die untersuchten Phänomene: Weisen die täglichen logarithmierten Renditen eines Leitindex zeitliche Abhängigkeiten und Häufungen hoher Volatilität auf? Als Datenbasis genügen Datum und Schlusskurs über fünf Jahre, je nach Börsenkalender also etwa 1.250 Beobachtungen.
Vor jeder Schätzung steht die Datenprüfung. Fehlende Kalendertage sind normal, weil Wochenenden und Feiertage dazugehören. Kritisch sind dagegen:
- doppelte Zeitstempel für denselben Handelstag,
- unplausible Nullwerte oder Lücken mitten in einer Handelswoche,
- gemischte Zeitzonen sowie eine fehlerhafte Sortierung.
Eine Zeitreihe ist kein beliebig vertauschbarer Datensatz: die Reihenfolge der Beobachtungen trägt selbst Information.
Auch im Finance Bereich kommt ein ordentlicher Auswertungsplan jeder Programmierung zuvor
Von Kursniveaus zu Renditen
Viele Arbeiten starten bei den Kursniveaus. Das ist nachvollziehbar, methodisch aber riskant, weil Indizes über längere Zeiträume häufig einem Trend folgen und damit nicht stationär sind. Stationarität bedeutet vereinfacht, dass Mittelwert und Varianz über die Zeit nicht systematisch wandern; viele Standardverfahren setzen genau das voraus.
Deshalb transformierst du die Kurse in logarithmierte Renditen: Die Rendite eines Handelstages ist der natürliche Logarithmus des Verhältnisses von aktuellem Schlusskurs zum Schlusskurs des Vortags. Solche Renditen sind über Zeiträume hinweg vergleichbar und lassen sich bei kleinen Änderungen näherungsweise addieren; für die Darstellung kannst du sie mit 100 multiplizieren und in Prozent berichten.
Danach lohnen drei Grafiken: Kursverlauf, Renditeverlauf und Histogramm der Renditen. Üblich ist ein trendbehafteter Kurs, während die Renditen um null schwanken und einzelne extreme Ausschläge zeigen, etwa in Krisenphasen oder rund um Zinsentscheidungen. Solche Extremwerte solltest du nicht vorschnell löschen, denn sie bilden oft genau das Verhalten ab, das dich interessiert.
Formal prüfst du Stationarität mit einem erweiterten Test nach Dickey und Fuller. Häufig bleibt er für Kursniveaus ohne Signifikanz, während er für Renditen signifikant ausfällt. Damit sind nicht alle Annahmen erfüllt, aber die Renditen sind die sinnvollere Zielgröße.
Autokorrelation prüfen und ein Modell wählen
Nun fragst du, ob heutige Renditen mit früheren zusammenhängen. Autokorrelationsfunktion und partielle Autokorrelationsfunktion zeigen, bei welchen Verzögerungen (ein Tag, zwei Tage, mehrere Tage) Zusammenhänge auftreten. Bei täglichen Aktienrenditen ist die lineare Autokorrelation im Mittelwert meist gering. Das ist kein Misserfolg, sondern ein Befund: einfache Kursmuster liefern keine belastbare kurzfristige Prognose.
Fällt die erste Verzögerung schwach, aber auffällig aus, kannst du ein ARIMA Modell mit einem autoregressiven Term schätzen; weil du stationäre Renditen modellierst, bleibt der Differenzierungsparameter bei null. Für die Modellwahl reicht ein einzelnes Kriterium nicht: AIC und BIC vergleichen plausible Spezifikationen, gewichten zusätzliche Parameter aber unterschiedlich streng. Zeigt ein Test nach Ljung und Box weiterhin serielle Korrelation in den Residuen, erfasst das Modell die zeitliche Struktur unzureichend.
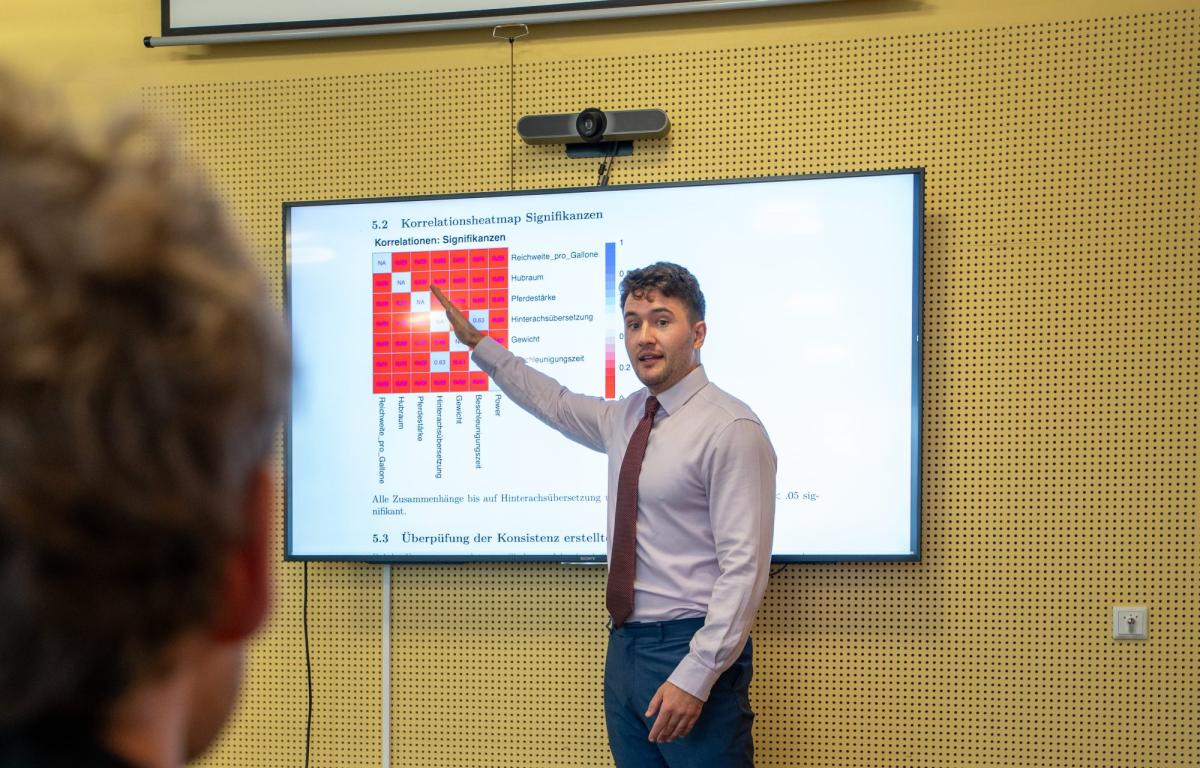
Mit einer Korrelationsheatmap lässt sich ein schneller Überblick über die Zusammenhänge alle metrischen Skalen gewinnen
Volatilität mit GARCH beschreiben
Bei Finanzzeitreihen liegt die spannendere Dynamik oft in der Varianz: auf stark bewegte Handelstage folgen häufig weitere unruhige Tage, und ruhige Phasen treten ebenfalls gebündelt auf. Dieses Muster heißt Volatilitätsclustering.
Ein Test auf ARCH Effekte zeigt, ob die Varianz der Modellfehler systematisch über die Zeit variiert. Ist das so, bietet sich ein Modell des Typs GARCH(1,1) an: es erklärt die heutige bedingte Varianz aus dem Fehler der Vorperiode und der zuvor geschätzten Varianz. So trennst du zwei Fragen, die oft vermischt werden: Lässt sich die Richtung der Renditen vorhersagen, und lässt sich das Ausmaß künftiger Schwankungen beschreiben?
Typisch ist ein Ergebnis, in dem der Effekt der Vortagesrendite winzig bleibt, die Volatilität dagegen deutliche Persistenz zeigt. Korrekt formuliert: die Richtung täglicher Renditen ist kaum prognostizierbar, das erwartbare Schwankungsniveau weist jedoch zeitliche Abhängigkeit auf. Eine statistische Prognose beschreibt Muster unter klar benannten Annahmen; eine Anlageempfehlung ist sie nicht.
Prognosegüte ohne Datenleckage bewerten
Ein verbreiteter Fehler ist, ein Modell über den gesamten Zeitraum zu schätzen und seine Güte an denselben Daten zu messen; die Ergebnisse werden dadurch zu optimistisch. Respektiere die zeitliche Abfolge: schätze etwa auf den ersten vier Jahren und prognostiziere das letzte Jahr. Für Renditen berichtest du Kennzahlen wie MAE oder RMSE, für die Volatilität zusätzlich, ob Phasen erhöhter Unsicherheit erkannt werden.
Alternativ aktualisierst du das Modell nach jedem Handelstag mit dem dann verfügbaren Informationsstand (Rolling Forecast). Das ist realitätsnäher, aber rechenintensiver und erklärungsbedürftiger; für eine Bachelorarbeit oder Masterarbeit überzeugt meist die transparente Trennung zwischen Trainingszeitraum und Testzeitraum. Weitere Beispiele zur Methodenwahl finden sich im Ratgeber zu Statistik und Datenanalyse.
Ergebnisse nachvollziehbar berichten
Ein starker Ergebnisteil verbindet Tabellen mit Einordnung. Nenne Stichprobenzeitraum, Datenfrequenz, Anzahl der Beobachtungen und die Definition der Rendite, anschließend deskriptive Kennwerte wie Mittelwert, Standardabweichung, Minimum, Maximum, Schiefe und Kurtosis; eine hohe Kurtosis deutet auf die für Finanzdaten typischen extremen Bewegungen hin.
Zu jedem Modell gehören Spezifikation, Koeffizienten, Standardfehler, Konfidenzintervalle und Diagnostik. Bei über tausend Handelstagen kann ein signifikanter Effekt wirtschaftlich unbedeutend sein, deshalb zählt die Effektgröße ebenso. Benenne außerdem Grenzen: ein einzelner Index, historische Schlusskurse, mögliche Strukturbrüche, Transaktionskosten, Feiertagseffekte und externe Schocks.
Fazit
Belastbar wird eine Zeitreihenanalyse von Finanzdaten nicht durch komplizierte Verfahren, sondern durch nachvollziehbare Schritte: geprüfte Daten, begründete Transformation, getestete Annahmen, eine klare Trennung von Schätzung und Bewertung sowie eine Interpretation, die Reichweite und Grenzen offenlegt.