
Data Mining im Unternehmen: So findest du verborgene Muster in deinen Daten

Data-Mining-Beratung: Verborgene Datenmuster erkennen und Entscheidungen treffen.
Dein Unternehmen sammelt jeden Tag Daten: Kunden kaufen ein, nutzen digitale Services, reagieren auf Kampagnen oder ändern still ihr Verhalten. Dazu kommen Informationen aus Produktion, Vertrieb und Verwaltung. Klingt nach einem Schatz, oder? Nur: Daten allein sind noch keine Erkenntnisse.
In vielen Firmen landen sie in Monatsberichten und Kennzahlen-Dashboards. Beschrieben wird, was passiert ist. Warum es passiert ist und welche Muster dahinterstecken, bleibt oft offen. Genau hier setzt Data Mining an. In diesem Artikel erfährst du, wie es funktioniert, welche Methoden wirklich relevant sind, welche Fehler du vermeiden solltest und wann sich externe Unterstützung lohnt.
Data Mining verstehen und sinnvoll einsetzen
Was ist Data Mining?
Data Mining ist die systematische Untersuchung von Daten, um Muster, Zusammenhänge und Strukturen zu finden, die nicht auf der Hand liegen. Dabei nutzt du Statistik, Machine Learning und algorithmische Analyse.
Ein Beispiel: Der durchschnittliche Umsatz pro Kunde steigt. Eine klassische Auswertung beschreibt das. Data Mining fragt weiter: Welche Kundengruppen treiben das Wachstum? Welche Verhaltensmuster gehen mit höheren Ausgaben einher? Lassen sich künftige Käufe vorhersagen?
Und noch etwas: Data Mining ist nicht automatisch künstliche Intelligenz. Auch Regressions- oder Clusteranalysen gehören dazu. Mehr zu den Grundlagen findest du im Beitrag Was ist Data Mining?.
Warum Muster oft unentdeckt bleiben
Die häufigsten Gründe:
- Daten liegen verstreut: Datenbanken, Excel-Listen und CRM-Systeme sind nicht verknüpft, also bleiben Zusammenhänge verborgen.
- Kennzahlen stehen isoliert: Eine durchschnittliche Kundenbindungsrate verdeckt, dass manche Kunden regelmäßig bestellen und andere nur bei Rabattaktionen auftauchen.
- Die Datenqualität leidet: Fehlende Werte, Dubletten oder inkonsistente Kategorien erzeugen Scheinmuster.
- Die Analysefrage fehlt: Wer einfach alles auswertet, bekommt viele Ergebnisse ohne praktische Bedeutung.
Was Data Mining dir bringen kann
- Kundenverhalten besser verstehen: Segmentierung zeigt, welche Kunden ähnlich ticken.
- Risiken früher erkennen: Modelle schätzen die Wahrscheinlichkeit von Abwanderung, Zahlungsausfällen oder Störungen. Sicher sind solche Prognosen nie, aber sie machen Risiken greifbarer.
- Prozesse verbessern: Du erkennst, unter welchen Bedingungen Qualitätsprobleme gehäuft auftreten.
- Fundierter entscheiden: Weniger Bauchgefühl, mehr Datenbasis. Die fachliche Interpretation bleibt trotzdem unverzichtbar.
Fünf typische Einsatzgebiete
1. Kundensegmentierung
Alter, Region oder Umsatz sind bequeme Kategorien, bilden aber selten echtes Verhalten ab. Eine Clusteranalyse gruppiert Kunden anhand mehrerer Merkmale gleichzeitig, etwa Bestellanzahl, Warenkorbwert, Zeit seit dem letzten Kauf, Rabattanteil, Retouren und Produktkategorien. Mögliche Ergebnisse: Stammkunden, Gelegenheitskäufer, Preisjäger. Aber Vorsicht: Cluster hängen von Variablenauswahl, Skalierung und Verfahren ab. Prüfe, ob die Gruppen stabil, interpretierbar und praktisch nützlich sind.
2. Kundenabwanderung vorhersagen
Hinweise liefern etwa sinkende Nutzung, Beschwerden, verändertes Bestellverhalten, Kundendauer, Vertragsmerkmale oder frühere Reaktionen auf Angebote. Typische Modelle sind logistische Regression, Entscheidungsbäume und Random Forests. Wichtig: Das Modell muss auch bei neuen, unbekannten Fällen zuverlässig funktionieren. Und ein hohes Abwanderungsrisiko heißt nicht, dass eine bestimmte Gegenmaßnahme wirkt.
3. Warenkorbanalyse
Mit der Assoziationsanalyse findest du Produkte, die auffällig oft zusammen gekauft werden. Support, Confidence und Lift helfen bei der Bewertung. Doch gemeinsame Käufe beweisen keine Kausalität. Als Impuls für Sortiment und Empfehlungen taugen sie trotzdem.
4. Anomalieerkennung
Manchmal ist das Ungewöhnliche interessant: auffällige Temperaturverläufe in Maschinen oder seltsame Transaktionsmuster im Finanzbereich. Eine statistische Auffälligkeit ist aber nicht automatisch ein Fehler oder Betrug. Prüfe sie immer im fachlichen Kontext.
5. Umsatz- und Nachfrageprognosen
Zeitreihenmodelle, Regression oder Machine Learning schätzen Absatz und saisonale Schwankungen. Wichtig ist dabei eine zeitlich korrekte Validierung: Das Modell darf nur Informationen verwenden, die zum jeweiligen Prognosezeitpunkt tatsächlich verfügbar gewesen wären. Andernfalls kann die Vorhersagegenauigkeit erheblich überschätzt werden.
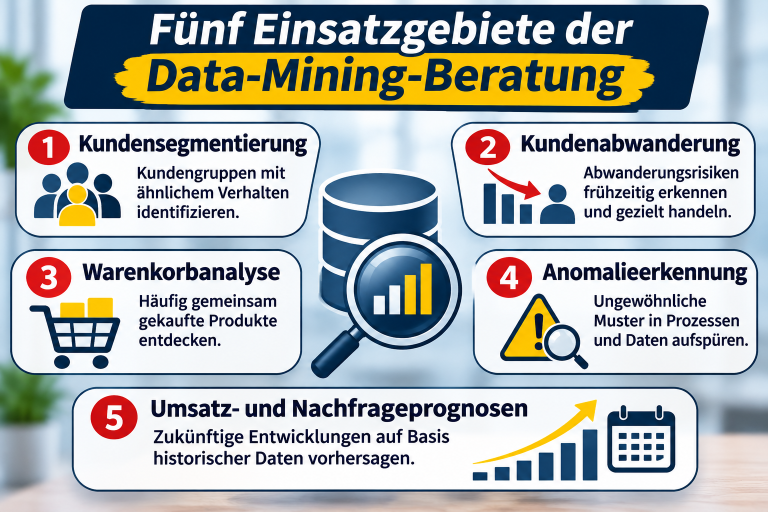
Fünf Einsatzgebiete der Data-Mining-Beratung: Von Kundensegmentierung bis Umsatzprognose.
Welche Methoden passen wozu?
Nicht jedes Unternehmen braucht neuronale Netze. Oft liefern einfache Verfahren bereits starke Ergebnisse, und interpretierbare Modelle lassen sich Entscheidern leichter erklären.
| Methode | Typische Fragestellung | Möglicher Nutzen |
|---|---|---|
| Clusteranalyse | Welche Beobachtungen ähneln sich? | Kundensegmentierung |
| Klassifikation | Zu welcher Kategorie gehört ein Fall? | Risikoeinschätzung |
| Regression | Wie hängt eine Zielgröße mit anderen Merkmalen zusammen? | Prognosen und Zusammenhangsanalysen |
| Entscheidungsbäume | Welche Merkmalskombinationen sind relevant? | Verständliche Vorhersageregeln |
| Random Forest | Lassen sich komplexere Muster nutzen? | Leistungsfähige Prognosemodelle |
| Assoziationsanalyse | Welche Ereignisse treten gemeinsam auf? | Warenkorbanalyse |
| Anomalieerkennung | Was ist ungewöhnlich? | Qualitätskontrolle und Monitoring |
| Zeitreihenanalyse | Wie entwickeln sich Kennzahlen über die Zeit? | Absatz- und Nachfrageprognosen |
So läuft ein Projekt ab
Bewährt hat sich ein iteratives Vorgehen nach dem Prozessmodell CRISP-DM:
CRISP-DM (Cross-Industry Standard Process for Data Mining) beschreibt ein strukturiertes Vorgehen bei Data-Mining-Projekten. Das Modell umfasst sechs Phasen: Geschäftsverständnis, Datenverständnis, Datenvorbereitung, Modellierung, Evaluation und Bereitstellung. Entscheidend ist dabei der iterative Charakter: Die Phasen werden nicht zwangsläufig nacheinander abgeschlossen. Zeigt sich beispielsweise während der Modellierung, dass die Datenqualität unzureichend ist, kann eine erneute Datenaufbereitung erforderlich werden. Ergibt die Evaluation, dass die entwickelten Modelle das ursprüngliche Geschäftsziel nicht ausreichend unterstützen, muss möglicherweise sogar die Zielsetzung überarbeitet werden. CRISP-DM ermöglicht damit eine systematische Anpassung des Analyseprozesses an neue Erkenntnisse. Die Phasen des CRISP-DM umfassen hierbei:
- Geschäftsproblem klären: Zum Beispiel: Wer hat ein erhöhtes Abwanderungsrisiko? Lege auch fest, woran du Erfolg misst.
- Datenbestand prüfen: Umfang, Variablen, Formate, fehlende Werte, Zeitstruktur, Verzerrungen und Datenschutz. Schon hier kann sich zeigen, dass eine Analyse so nicht möglich ist.
- Daten aufbereiten: Bereinigen, Quellen zusammenführen, neue Variablen bilden. Vermeide Datenleckage, also unzulässig einfließende Informationen aus Test- oder Validierungsdaten.
- Modelle entwickeln: Starte mit einem einfachen Vergleichsmodell. Komplexere Verfahren nutzt du erst, wenn sie nachweisbar mehr bringen.
- Ergebnisse validieren: Je nach Aufgabe zählen Precision, Recall, ROC-AUC, Kalibrierung oder Prognosefehler auf unabhängigen Testdaten. Bei Clustern zählen Stabilität und Interpretierbarkeit.
- In Entscheidungen übersetzen: Verknüpfe die Erkenntnisse mit der Ausgangsfrage und prüfe, ob Maßnahmen wirtschaftlich sinnvoll, rechtlich zulässig und machbar sind.
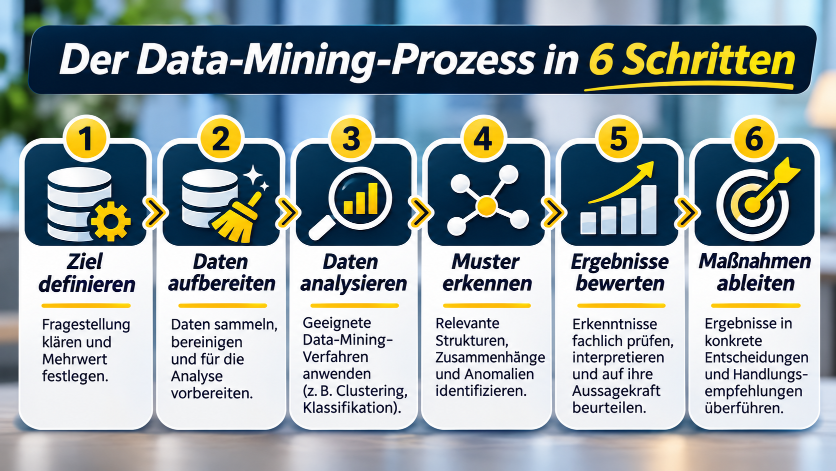
Der Data-Mining-Prozess in sechs Schritten. Von der Zieldefinition bis zur Umsetzung.
Ein Beispiel aus der Praxis
Stell dir ein Unternehmen vor, das Umsätze und aktive Kunden kennt, aber nicht weiß, ob sich Verhaltensmuster zeigen. Nach der Datenprüfung werden Kaufhäufigkeit, Bestellwert und Zeit seit dem letzten Kauf aufbereitet. Eine Clusteranalyse könnte drei Segmente ergeben:
- Regelmäßige Käufer: bestellen oft, stabile Aktivität.
- Gelegentliche Käufer: bestellen seltener, aber mit höheren Warenkörben.
- Inaktive Kunden: haben lange nichts mehr bestellt.
Danach prüfst du, ob die Einteilung stabil ist und mehr Erkenntnis bringt als einfache Kennzahlen. Erst dann testest du, ob unterschiedliche Ansprache wirklich unterschiedlich wirkt.
Data Mining oder klassische Statistik?
Beides ergänzt sich. Klassische Statistik prüft meist vorab formulierte Hypothesen oder schätzt Parameter. Data Mining ist oft explorativer oder prognoseorientiert. Die Grenzen sind fließend: Eine Regression kann eine Hypothese testen oder Kundenverhalten vorhersagen. Entscheidend ist das Analyseziel. Willst du einen Zusammenhang möglichst unverzerrt schätzen, gelten andere Anforderungen als bei einem Prognosemodell.
Fehler, die du vermeiden solltest
- Overfitting: Das Modell beschreibt Trainingsdaten glänzend und versagt bei neuen Fällen. Eine saubere Validierung deckt das auf.
- Korrelation ist nicht Kausalität: Mehr Marketingkontakte bei aktiven Kunden heißen nicht, dass die Kontakte die Käufe verursachen.
- Datenqualität unterschätzen: Selbst der beste Algorithmus repariert keine fehlerhaften Daten.
- Falsche Kennzahlen: Sind 98 Prozent der Transaktionen unauffällig, erreicht ein Modell, das nie einen Auffälligkeitsfall erkennt, trotzdem 98 Prozent Accuracy.
- Keine Praxisprüfung: Eine statistische Struktur ist nicht automatisch wirtschaftlich relevant.
Externe Beratung, Kosten und Auswahl
Wann sich externe Unterstützung lohnt
Nicht jede Firma braucht eine eigene Data-Science-Abteilung. Externe Hilfe ist sinnvoll, wenn du erstmals größere Datenbestände analysierst, methodisches Spezialwissen fehlt, Verfahren ausgewählt oder bestehende Modelle geprüft werden müssen, die Aussagekraft von Ergebnissen unklar ist oder du erst die Machbarkeit testen willst. Eine gute Data Mining Beratung startet nicht mit maximaler Modellierung, sondern prüft, welche Analysen mit deinen Daten realistisch sind.
| Kriterium | Interne Datenanalyse | Externe Beratung |
|---|---|---|
| Fachwissen | Abhängig von vorhandenen Kompetenzen | Spezialisierte Methodenkompetenz |
| Unternehmenskenntnis | Meist umfassend | Muss erst aufgebaut werden |
| Verfügbarkeit | Abhängig von internen Ressourcen | Projektbezogen vereinbar |
| Kosten | Personal und Infrastruktur | Auftragsbezogen |
| Unabhängigkeit | Abhängig von internen Abläufen | Externe Perspektive |
| Langfristige Nutzung | Direkt in Prozesse integriert | Übergabe und Dokumentation nötig |
Extern ist nicht automatisch besser. Wer regelmäßig komplexe Modelle betreibt, baut besser eigene Kompetenz auf. Auch Mischformen funktionieren: Dein Team liefert Fach- und Datenwissen, Externe übernehmen Modellierung und Validierung.
Was kostet das?
Pauschale Preise gibt es nicht. Die Kosten hängen ab von:
- Datenaufbereitung: Müssen Quellen zusammengeführt und umfangreich bereinigt werden?
- Methodischer Komplexität: Genügen etablierte Verfahren oder braucht es Machine Learning?
- Validierung: Wie streng soll die Übertragbarkeit auf neue Daten geprüft werden?
- Dokumentation: Reichen Ergebnisse oder brauchst du reproduzierbare Skripte?
- Technischer Integration: Einmalanalyse oder Einbindung in laufende Prozesse?
Beschreibe dein Vorhaben vorab möglichst konkret. Bei größeren Projekten hilft ein begrenzter Proof of Concept: Er zeigt, ob deine Daten taugen und die Verfahren Nutzen bringen, bevor du mehr investierst.
Woran du seriöse Anbieter erkennst
- Methodische Kompetenz: Sie erklären, warum ein Verfahren passt und wo seine Grenzen liegen.
- Transparenz: Aufbereitung, Modellierung und Validierung sind dokumentiert.
- Realismus: Keine Erfolgsgarantien, keine perfekten Prognosen.
- Verständlichkeit: Ergebnisse sind auch ohne Statistikstudium nachvollziehbar.
- Datenschutz: Besonders bei Kunden-, Beschäftigten- oder Gesundheitsdaten.
- Reproduzierbarkeit: Soweit vereinbart und möglich.
Und: Eine gute Beratung sagt dir offen, wenn eine geplante Analyse mit deinen Daten keinen Sinn ergibt.
Welche Daten du brauchst
Das hängt von der Frage ab: Transaktions- und Nutzungsdaten für Segmentierung, historische Zeitreihen für Prognosen, Maschinen- und Sensordaten für Qualitätskontrolle. Klär vorab:
- Welche Geschäftsfrage soll beantwortet werden?
- Welche Datenquellen gibt es und über welchen Zeitraum?
- Wie vollständig und zuverlässig sind sie?
- Gibt es bekannte Erfassungsprobleme oder rechtliche Beschränkungen?
- Wie sollen die Ergebnisse später genutzt werden?
Große Datenmengen sind nicht immer nötig. Auch kleinere Datensätze können reichen, wenn sie zur Analyse passen.
Fazit: Erst die richtige Frage, dann der Algorithmus
In vielen Unternehmen schlummert ungenutztes Potenzial in den Daten. Data Mining hilft dir, Muster zu erkennen, Kundengruppen zu unterscheiden, Risiken einzuschätzen und Entwicklungen zu prognostizieren. Komplexe Algorithmen allein schaffen aber keinen Mehrwert. Den bringen erst saubere Daten, passende Modelle, nachvollziehbare Validierung und fachliche Interpretation.
Dein nächster Schritt: Formuliere heute eine konkrete Geschäftsfrage und prüfe, welche Daten dazu vorliegen. Schon eine kleine Machbarkeitsprüfung zeigt dir, ob sich der Einstieg lohnt.
Ist Data Mining nur für große Unternehmen geeignet?
Nein. Auch kleine und mittelständische Unternehmen können Data Mining nutzen, wenn eine geeignete Fragestellung und aussagekräftige Daten vorliegen. Der Nutzen muss im Verhältnis zum Aufwand stehen.
Brauche ich besonders große Datenmengen?
Nicht grundsätzlich. Die nötige Menge hängt von Fragestellung, Verfahren und Datenstruktur ab. Komplexe Modelle brauchen meist mehr Daten als einfache statistische Verfahren.
Welche Software wird verwendet?
Häufig kommen R und Python zum Einsatz, daneben Plattformen wie KNIME, SPSS Modeler oder SAS. Die Wahl richtet sich nach fachlichen und technischen Anforderungen.
Kann Data Mining Kundenverhalten zuverlässig vorhersagen?
Es ermöglicht Prognosen, deren Zuverlässigkeit von Datenqualität, Stabilität der Zusammenhänge und Validierung abhängt. Vollständige Sicherheit gibt es nicht.
Was ist der Unterschied zwischen Data Mining und Machine Learning?
Data Mining ist vor allem der Prozess, relevante Muster aus Daten zu gewinnen. Machine Learning umfasst Verfahren, mit denen Modelle aus Daten lernen. Beide überschneiden sich stark.