
Data Mining verstehen - So hebst du wertvolle Erkenntnisse aus Daten

Data Mining: Muster in Daten entdecken und für Entscheidungen einordnen.
Data steckt überall, in Systemlogs, Umfragen, Messreihen und Kundenlisten. Doch Rohdaten sind erst einmal nur Zahlenmengen. Data Mining verwandelt diese Masse in handfeste Erkenntnisse, die Entscheidungen besser machen, Risiken reduzieren oder neue Chancen aufdecken.
Warum das für dich relevant ist? Weil heute fast jede Praxis, Abteilung oder Forschungsarbeit von Daten abhängt. Wenn du lernst, wie Data Mining funktioniert und worauf es wirklich ankommt, kannst du Probleme schneller lösen, bessere Fragestellungen formulieren und Ergebnisse so präsentieren, dass sie überzeugen.
Was ist Data Mining?
Data Mining bedeutet systematische Suche nach Mustern, Zusammenhängen und relevanten Informationen in großen oder komplexen Datensätzen. Du kannst es dir vorstellen wie Datenbergbau: Aus einer großen Menge Rohmaterial werden die wertvollen Bestandteile herausgelöst.
Kurz und knapp: Ziele und Abgrenzung
- Ziel: Muster entdecken, Gruppen bilden, Vorhersagen treffen und Entscheidungsprozesse unterstützen.
- Abgrenzung zur klassischen Statistik: Statistik prüft oft vorab formulierte Hypothesen, Data Mining ist stärker explorativ - es sucht neue, bislang unbekannte Strukturen.
Typischer Ablauf eines Data-Mining-Projekts
Ein professioneller Prozess folgt meist mehreren Schritten, die sich in der Praxis bewährt haben:
- Verstehen der Fragestellung - Was genau willst du wissen? Welche Entscheidungen hängen vom Ergebnis ab?
- Datenbeschaffung und -aufbereitung - Reinigung, Vereinheitlichung, Auffüllen fehlender Werte.
- Explorative Analyse - Erste Visualisierungen, Verteilungen, Ausreißer erkennen.
- Modellwahl und Modellierung - Auswahl geeigneter Algorithmen und Parameter.
- Evaluation - Modelle prüfen, Validierung durchführen, Überanpassung vermeiden.
- Operationalisierung - Ergebnisse bereitstellen, Modelle in Prozesse integrieren.
Besonders die Datenaufbereitung nimmt in der Praxis oft den größten Zeitanteil ein. Fehlende Werte, falsche Kodierungen oder inkonsistente Variablen führen sonst zu trügerischen Ergebnissen.
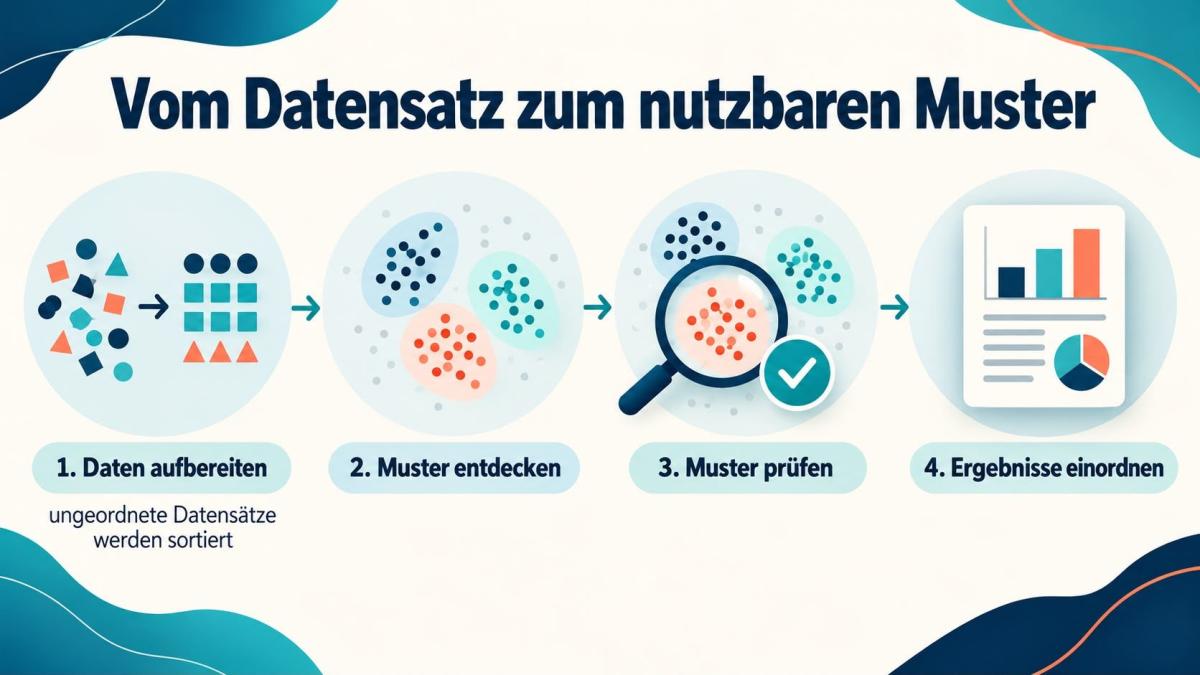
Vom Aufbereiten bis zur Einordnung: Vier Schritte im Data Mining.
Wie du Data Mining praktisch anwendest
Data Mining lebt von Methodenvielfalt. Welche Technik du wählst, hängt vom Ziel, der Datenstruktur und der Frage ab. Hier eine kompakte Übersicht mit Einsatzszenarien.
| Methode | Wann einsetzen | Vorteil | Nachteil |
|---|---|---|---|
| Clusteranalyse | Wenn du natürliche Gruppen finden willst | Erkennt Segmentstrukturen leicht | Ergebnis oft interpretationsbeduerftig |
| Klassifikation | Wenn du Kategorien vorhersagen willst | Klare Zuordnung, einfache Bewertung | Braucht gelabelte Trainingsdaten |
| Regression | Wenn du kontinuierliche Werte prognostizierst | Gute Erklärbarkeit, robuste Verfahren | Lineare Annahmen nicht immer passend |
| Entscheidungsbaum | Wenn Regeln visualisiert werden sollen | Intuitiv, gut für Handlungsempfehlungen | Neigt zu Overfitting |
| Neuronale Netze | Bei sehr komplexen Vorhersageproblemen | Hohe Leistung bei großen Datenmengen | Bedarf viel Daten und Rechenleistung |
Praxis-Tipps - so startest du richtig
- Fang klein an: Definiere eine konkrete Fragestellung und ein überschaubares Teilprojekt.
- Investiere Zeit in Datenqualität: Bereinigen und einheitliche Formate zahlen sich am stärksten aus.
- Validierung ist Pflicht: Nutze Kreuzvalidierung oder Hold-out-Sets, um Overfitting zu vermeiden.
- Dokumentiere Entscheidungen: Modellwahl, Metriken und Annahmen müssen nachvollziehbar sein.
Software und Tools
Für die Umsetzung stehen mehrere Sprachen und Plattformen bereit. Besonders verbreitet sind Python und R, da sie umfangreiche Bibliotheken für Analyse und Machine Learning bieten. Für Anwender ohne Programmieraufwand gibt es Werkzeuge wie SPSS Modeler, RapidMiner oder KNIME.
Typische Fehler und wie du sie vermeidest
- Schlechte Datenqualität - regelmäßig prüfen und säubern.
- Verwechslung von Korrelation und Kausalität - hinterfrage Zusammenhänge kritisch.
- Overfitting - nutze Validierung und einfache Baseline-Modelle als Referenz.
- Zu kleine Stichprobe - sicherstellen, dass Ergebnisse statistisch abgesichert sind.
Wann professionelle Unterstützung Sinn macht
Ziehe spezialisierte Beratung hinzu, wenn Datensätze extrem groß oder komplex sind, Machine-Learning-Verfahren produktiv eingesetzt werden sollen oder wenn methodische Sicherheit in wissenschaftlichen Arbeiten erforderlich ist.
Fazit
Data Mining ist kein Hexenwerk, sondern eine strukturierte Vorgehensweise: Klar formulierte Fragen, saubere Daten, passende Methoden und sorgfältige Evaluation. Wer diese Schritte befolgt, macht aus Rohdaten belastbare Erkenntnisse, die echte Entscheidungen unterstützen.
Probier es heute aus: Formuliere eine konkrete Frage, nimm 20-100 relevante Datensätze und versuche eine einfache Clusteranalyse oder Regression - du wirst überrascht sein, welche Einsichten schnell sichtbar werden.
Was ist der Unterschied zwischen Data Mining und Machine Learning?
Data Mining konzentriert sich auf das Erkennen von Mustern und das Gewinnen von Erkenntnissen aus Daten; Machine Learning beschreibt das automatisierte Lernen von Modellen aus Daten und wird häufig als Methode innerhalb von Data-Mining-Projekten eingesetzt.
Welche Programmiersprache sollte ich lernen?
Für die Praxis sind Python und R empfehlenswert - Python punktet mit breiter Anwendungspalette und vielen Bibliotheken, R ist besonders stark bei statistischer Analyse und Visualisierung.
Wie lange dauert es, bis sich Ergebnisse zeigen?
Bei einem kleinen, gut definierten Teilprojekt siehst du oft innerhalb weniger Tage erste Erkenntnisse; für robuste, produktive Modelle solltest du mehrere Iterationen und Validierungszyklen einplanen.
Wie vermeide ich Overfitting?
Nutze Hold-out-Sets oder Kreuzvalidierung, vergleiche mit einfachen Baseline-Modellen und reduziere die Modellkomplexität, wenn die Leistung auf neuen Daten abfällt.