Fallzahl richtig planen: So begründest du die Stichprobengröße deiner Studie

Schreibtisch mit Laptop und unscharfen Diagrammseiten
Eine Studie kann sorgfältig geplant sein und trotzdem ins Leere laufen, wenn die Stichprobe zu klein bleibt. Ein real vorhandener Effekt wird dann statistisch nicht sichtbar. Eine unnötig große Stichprobe kostet dagegen Zeit, Budget und bei klinischen oder sensiblen Erhebungen auch Ressourcen, die an anderer Stelle fehlen.
Die Fallzahlplanung ist deshalb keine Formsache. Sie übersetzt deine Annahmen über den erwarteten Effekt in eine konkrete Zahl, die du in Thesis, Dissertation oder Studienprotokoll begründen musst. Wer diese Begründung früh dokumentiert, spart sich später viele Rückfragen im Methodenteil.
Was eine Poweranalyse beantwortet
Die Poweranalyse klärt eine praktische Frage: Wie viele Fälle brauchst du, um einen Effekt einer bestimmten Größe mit hoher Wahrscheinlichkeit als statistisch signifikant zu erkennen? Die statistische Power ist genau diese Wahrscheinlichkeit. Üblich sind 80 Prozent, bei konfirmatorischen, klinischen oder besonders aufwendigen Vorhaben häufig 90 Prozent. Bleiben 20 Prozent Risiko, einen echten Effekt zu übersehen, spricht man vom Betafehler oder Fehler zweiter Art.
Der Zeitpunkt entscheidet über die Variante. Eine Analyse vor der Erhebung (a priori) liefert die erforderliche Stichprobengröße. Steht der Datensatz schon fest, etwa bei Sekundärdaten, passt eine Sensitivitätsanalyse: Sie zeigt, welcher kleinste Effekt mit der vorhandenen Fallzahl noch nachweisbar wäre. Eine post hoc berechnete Power nach einem nicht signifikanten Ergebnis sagt wenig aus, weil sie am beobachteten p Wert hängt; hilfreicher sind Konfidenzintervalle und eine nüchterne Einordnung der Effektgröße.
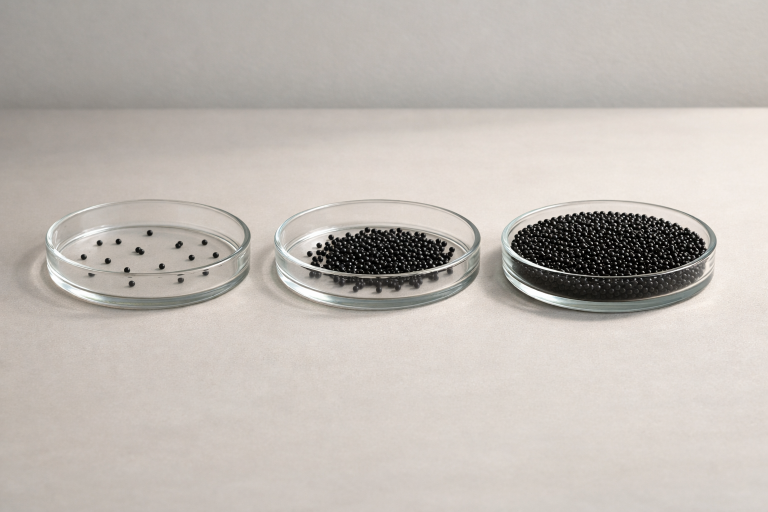
Drei Petrischalen mit unterschiedlicher Punktdichte als Effektgrößen
Die vier Stellschrauben deiner Fallzahl
Vier Größen greifen ineinander: Effektstärke, Signifikanzniveau, Zielpower und geplantes Testverfahren. Veränderst du eine davon, verschiebt sich die benötigte Fallzahl.
Effektstärke begründen statt raten
Die Effektstärke beschreibt, wie deutlich ein erwarteter Unterschied oder Zusammenhang ausfällt. Bei Mittelwertvergleichen wird meist Cohen's d verwendet, bei Zusammenhängen der Korrelationskoeffizient r, bei Varianzanalysen f und bei multiplen Regressionen f². Je kleiner der erwartete Effekt, desto mehr Fälle sind nötig. Faustregeln wie klein, mittel oder groß geben eine erste Orientierung, ersetzen aber keine fachliche Herleitung aus vergleichbaren Studien, Metaanalysen, Pilotdaten oder einer inhaltlich definierten kleinsten relevanten Differenz. Bei Pilotdaten gilt Vorsicht: Kleine Stichproben liefern instabile Schätzungen, und ein zufällig großer Piloteffekt führt zu einer zu klein geplanten Hauptstudie.
Alphaniveau und Testseitigkeit
Alpha legt fest, wie hoch das Risiko eines falsch positiven Befunds sein darf; üblich sind 5 Prozent. Ein strengeres Niveau von 1 Prozent senkt dieses Risiko, erhöht aber die Fallzahl. Ein einseitiger Test benötigt weniger Fälle, ist jedoch nur zulässig, wenn eine Wirkung in Gegenrichtung fachlich vorab ausgeschlossen ist. Erst nach dem Blick in die Daten einseitig zu testen, ist ein methodischer Mangel.
Zielpower realistisch wählen
80 Prozent sind eine Konvention, keine Vorschrift. Bei folgenschweren Fragestellungen, seltenen Endpunkten oder teurer Erhebung können 90 Prozent angemessen sein. Lässt sich nur eine begrenzte Zahl von Personen rekrutieren, hilft eine hohe Zielpower auf dem Papier wenig: Ein unrealistischer Rekrutierungsplan gefährdet die gesamte Studie.
Testverfahren und Studiendesign
Die Fallzahl folgt dem konkreten Analysemodell. Ein t Test für unabhängige Gruppen, eine gepaarte Messung, eine Korrelation, eine lineare oder logistische Regression, eine Varianzanalyse mit mehreren Gruppen oder ein Mehrebenenmodell verlangen jeweils eigene Annahmen. Oft unterschätzt werden Kovariaten, ungleiche Gruppengrößen (etwa ein Verhältnis von 2:1), Messwiederholungen und Clusterstrukturen. Bilden Schulen, Praxen oder Stationen die Erhebungseinheiten, muss die Ähnlichkeit innerhalb der Cluster einfließen, sonst überschätzt du den Informationsgehalt deiner Daten.
In dieser Reihenfolge planst du sinnvoll
- Primäre Hypothese präzise formulieren: abhängige Variable, Gruppen oder Prädiktoren und geplanter Test.
- Den kleinsten inhaltlich relevanten Effekt festlegen und die Quellen dieser Annahme dokumentieren.
- Alphaniveau, Testseitigkeit und Zielpower bestimmen und mit dem Studiendesign begründen.
- Die Parameter in passender Software eingeben; für Standardtests reichen etablierte Programme, komplexe Designs erfordern Lösungen in R, Stata oder vergleichbaren Umgebungen.
- Das Ergebnis auf Machbarkeit prüfen und erwartete Ausfälle einrechnen.
Die berechnete Mindestfallzahl ist selten die Zahl, die du rekrutieren musst. Unvollständige Fragebögen in einer Onlinebefragung oder Ausfälle in einer Längsschnittstudie verkleinern die auswertbare Stichprobe. Rechne den Aufschlag korrekt auf die Zielgröße: Für 128 auswertbare Fälle bei 15 Prozent Ausfall sind rund 151 rekrutierte Personen nötig, nicht 143. Vertiefende Beiträge zu einzelnen Verfahren findest du im Ratgeber zu Statistik und Datenanalyse.
Leerer Hörsaal mit gruppierten Tischen, einzelne Plätze entfernt
Fehler, die sich leicht vermeiden lassen
- Falscher Test: Wer eine Korrelation plant, später aber eine multiple Regression mit mehreren Kovariaten berichtet, hat nicht automatisch genug Power für das endgültige Modell.
- Interaktionseffekte unterschätzen: Sie sind meist kleiner als Haupteffekte und brauchen deutlich mehr Fälle.
- Literaturwerte unkritisch übernehmen: Prüfe Population, Messinstrument, Vergleichsgruppen und Endpunkt, bevor du eine fremde Effektstärke ansetzt.
- Multiples Testen ignorieren: Mehrere gleichrangige Hypothesen können eine Korrektur erfordern, die wiederum die Fallzahl erhöht. Trenne primäre, sekundäre und explorative Analysen klar.
So berichtest du das Ergebnis
Ein guter Bericht ist kurz und vollständig: Verfahren, Annahmen und resultierende Mindeststichprobe. Eine Formulierung kann lauten: „Die a priori Poweranalyse für einen zweiseitigen Test bei unabhängigen Stichproben ergab bei α = ,05, einer angestrebten Power von ,80 und einer erwarteten Effektstärke von d = 0,50 eine erforderliche Stichprobe von 128 Personen.“ Nenne zusätzlich die verwendete Software samt Version. Bei komplexeren Modellen erläutere, wie du die Effektstärke hergeleitet hast, welche Prädiktoren eingeplant sind und wie du mit Ausfällen umgehst.
Fazit
Eine begründete Fallzahl garantiert keine signifikanten Ergebnisse. Sie sorgt aber dafür, dass deine Studie überhaupt die Chance hat, eine belastbare Antwort zu liefern. Transparente Annahmen sind dabei überzeugender als eine scheinbar perfekte Zahl ohne Herleitung.