Fallzahlplanung: So viele Patienten braucht deine klinische Studie wirklich

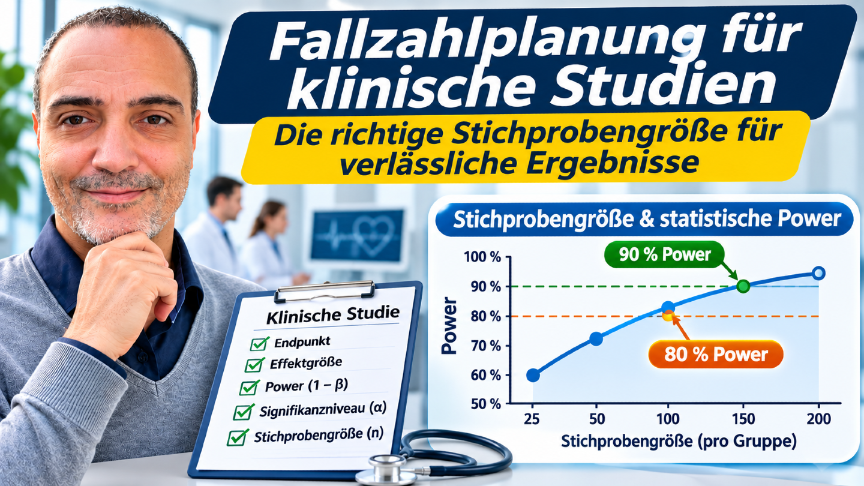
Fallzahlplanung klinischer Studien: Wie Stichprobengröße & Power zusammenhängen.
Stell dir vor, du hast Monate in eine klinische Studie investiert, Patientinnen und Patienten rekrutiert, Daten erhoben - und am Ende ist das Ergebnis nicht signifikant. Heißt das, die Behandlung wirkt nicht? Nicht unbedingt. Vielleicht war die Stichprobe schlicht zu klein, um einen echten Effekt zu erkennen. Genau deshalb gehört die Frage nach der Fallzahl zu den wichtigsten Entscheidungen jedes Forschungsprojekts.
Trotzdem wird sie oft zu spät gestellt: erst wenn das Design steht oder der Ethikantrag ansteht. Eine zu kleine Stichprobe liefert unscharfe Antworten. Eine unnötig große verursacht Kosten und belastet Teilnehmende ohne Grund. In diesem Artikel erfährst du, welche Größen in die Fallzahlberechnung einfließen, wie eine Beispielrechnung aussieht, welche Fehler du vermeiden solltest und was vor der ersten Datenerhebung geklärt sein muss.
Die Grundlagen: Was Fallzahlplanung leistet
Fallzahlplanung bedeutet mehr, als eine Zahl auszurechnen. Sie stimmt Forschungsfrage, Studiendesign, primären Endpunkt und Auswertungsverfahren aufeinander ab. Dabei hat sie auch eine ethische Dimension: Eine schwach geplante Studie setzt Menschen Belastungen aus, ohne dass aussagekräftige Ergebnisse realistisch sind. Umgekehrt sollten nicht mehr Personen als nötig teilnehmen.
Bei sehr großen Stichproben kann zudem schon ein winziger, klinisch unbedeutender Unterschied signifikant werden. Die medizinische Relevanz muss deshalb immer mitgedacht werden.
Die vier zentralen Stellschrauben
Bei der klassischen, testbasierten Planung zählen vier Größen:
- die klinisch relevante Effektgröße,
- das Signifikanzniveau (meist α = 0,05, zweiseitig),
- die gewünschte Power (meist 80 oder 90 Prozent),
- die Streuung der Daten beziehungsweise weitere Modellparameter.
Hinzu kommen Design, Gruppenzahl, Zuteilungsverhältnis und erwartete Ausfälle. Nicht jede Planung beruht dabei auf einem Signifikanztest: Manchmal steht die Genauigkeit einer Schätzung im Vordergrund, etwa die maximale Breite eines Konfidenzintervalls.
Schritt für Schritt zur Fallzahl
1. Forschungsfrage präzisieren
"Wirkt die neue Therapie?" reicht nicht. Lege Zielpopulation, Intervention, Vergleich, Endpunkt und Zeitraum fest. Ein Beispiel: Führt das neue Behandlungsprogramm nach zwölf Wochen zu einer stärkeren Senkung des systolischen Blutdrucks als die Standardversorgung? Kläre dann, ob du die Werte nach zwölf Wochen vergleichst oder die Veränderung zum Ausgangswert - die Fallzahl kann sich unterscheiden.
2. Primären Endpunkt festlegen
Der Endpunkt bestimmt das Verfahren und die nötigen Informationen. Typische Typen: kontinuierlich (Blutdruck, HbA1c), binär (Therapieerfolg), Zeit bis Ereignis, Zählvariable, ordinal oder wiederholt gemessen. Lege ihn vor der Datenerhebung fest. Sonst könnte die Auswahl von den Ergebnissen beeinflusst werden. Bei mehreren primären Endpunkten brauchst du außerdem eine Strategie für multiples Testen.
3. Klinisch relevanten Effekt bestimmen
Wie groß muss ein Unterschied sein, damit er medizinisch zählt? Etwa 5 mmHg zusätzliche Blutdrucksenkung? Begründe die Antwort mit früheren Studien, Übersichtsarbeiten, validierten Schwellenwerten oder Expertenurteilen. Unterscheide dabei zwischen erwartetem und klinisch relevantem Effekt. Stützt du dich nur auf einen optimistischen Effekt aus einer kleinen Pilotstudie, unterschätzt du leicht die nötige Stichprobe.
4. Signifikanzniveau und Power wählen
Eine Power von 80 Prozent heißt: Liegt der angenommene Effekt tatsächlich vor und stimmen die Modellannahmen, liefert die Studie bei häufiger Wiederholung in etwa 80 Prozent der Fälle ein signifikantes Ergebnis. Eine Garantie für eine einzelne Studie ist das nicht. Höhere Power oder kleinere Effekte verlangen meist größere Stichproben.
5. Streuung realistisch einschätzen
Je stärker die Messwerte variieren, desto schwerer lässt sich ein Unterschied nachweisen. Bei gleichem Effekt von 5 mmHg braucht eine Standardabweichung von 15 mmHg mehr Personen als eine von 10 mmHg. Nutze Daten aus vergleichbaren Studien, Registern oder der Routine, und prüfe Messinstrumente, Einschlusskriterien und Zeitpunkte. Bei Vorher-Nachher-Designs ist wichtig, ob du die Streuung der Einzelwerte oder der Veränderungswerte brauchst.
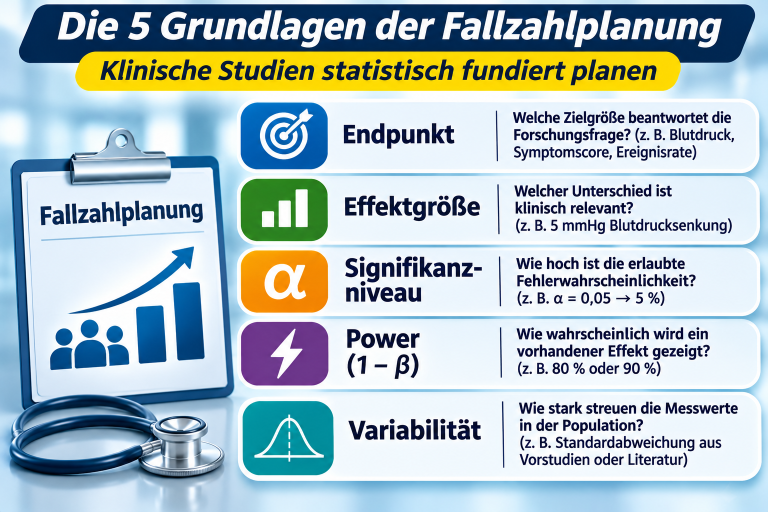
Die fünf Grundlagen der Fallzahlplanung: Endpunkt, Effektgröße, Signifikanzniveau, Power und Variabilität.
Rechnen, Designs und typische Stolperfallen
Eine Beispielrechnung
Zwei unabhängige Gruppen, 1:1, Unterschied 5 Einheiten, Standardabweichung 10 (Cohen's d = 0,5), α = 0,05 zweiseitig, Power 80 Prozent:
| Parameter | Festlegung |
|---|---|
| Relevanter Unterschied | 5 Einheiten |
| Standardabweichung | 10 Einheiten |
| Signifikanzniveau | α = 0,05, zweiseitig |
| Power | 80 % |
| Ergebnis (t-Test) | ca. 64 Personen pro Gruppe, 128 gesamt |
Rechnest du mit 15 Prozent nicht auswertbaren Teilnehmenden, teilst du durch 0,85: 64 / 0,85 ≈ 75,3. Du rekrutierst also mindestens 76 Personen pro Gruppe, insgesamt 152. Das ist eine vereinfachte Rechnung. Nicht jeder Abbruch bedeutet den vollständigen Verlust an Information, denn manche Längsschnittmodelle nutzen auch unvollständige Messreihen.
Das Design bestimmt die Methode
Ein Standardverfahren passt nicht auf jedes Design:
- Messwiederholungen: Werte einer Person sind korreliert, ein einfacher Gruppenvergleich genügt nicht.
- Cluster-Randomisierung: Personen im selben Cluster ähneln sich. Der Designeffekt DE = 1 + (m - 1) · ICC zeigt, warum 200 Personen aus wenigen Kliniken weniger Information liefern als 200 einzeln randomisierte.
- Cross-over: Berücksichtige die Korrelation innerhalb der Personen sowie Perioden- und Übertragungseffekte.
- Binäre Endpunkte: Hier zählen die erwarteten Ereigniswahrscheinlichkeiten, etwa 60 gegenüber 75 Prozent Erfolg. Je kleiner die Differenz, desto größer die Stichprobe.
- Überlebenszeiten: Entscheidend ist die Zahl der Ereignisse, nicht nur der Eingeschlossenen. Hazard Ratio, Ereignisrate, Rekrutierungsdauer, Nachbeobachtung und Zensierung spielen mit.
Überlegenheit, Nichtunterlegenheit, Äquivalenz
Nicht jede Studie will Überlegenheit zeigen. Bei Nichtunterlegenheit musst du eine fachlich begründete Grenze vorab festlegen, nie erst nach Sicht der Ergebnisse. Äquivalenz braucht eine andere Hypothesenstruktur.
Dropouts und fehlende Werte
Plane Ausfälle von Anfang an ein, aber nicht nur mit einem pauschalen Aufschlag. Ein Studienabbruch wirkt anders als ein verpasster Messtermin. Fehlen Daten systematisch bei ungünstigen Verläufen, entstehen Verzerrungen, die eine größere Stichprobe nicht behebt. Prüfe verschiedene Dropout-Szenarien in Sensitivitätsanalysen.
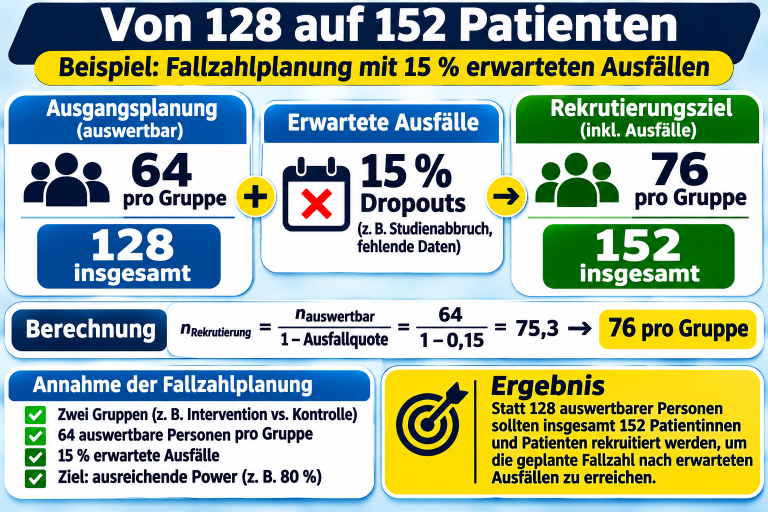
Fallzahlplanung: So werden aus 128 auswertbaren Personen bei 15 % Ausfällen 152 Patienten.
G*Power, Simulation und Co.
G*Power eignet sich für Standardverfahren wie t-Tests, Varianzanalysen oder Korrelationen. Der häufigste Fehler: erst eine verfügbare Testoption wählen und dann die Studie daran anpassen. Richtig ist die umgekehrte Reihenfolge: Forschungsfrage, Design, Endpunkt, Analyse - dann das Berechnungsverfahren.
Bei gemischten Modellen, komplexen Überlebenszeitanalysen, Clusterstudien oder adaptiven Designs helfen Simulationen. Du erzeugst dafür wiederholt künstliche Datensätze, wertest sie wie geplant aus und bestimmst die Power als Anteil erfolgreicher Durchläufe. So siehst du, wie empfindlich die Fallzahl auf Annahmen reagiert. Eine Simulation ist allerdings nur so gut wie ihr Modell.
Das gehört in die Fallzahlbegründung
Für Protokoll und Ethikantrag solltest du die Herleitung nachvollziehbar dokumentieren: primärer Endpunkt und Hypothese, Design, statistisches Verfahren, Effektannahme samt Begründung, weitere Parameter wie Standardabweichung, α, Power, auswertbare Fallzahl, Dropout-Annahmen und Rekrutierungsziel. Nenne auch Software, Berechnungsmethode und die Herkunft der Annahmen.
Besonderheiten bei Dissertationen
Bei prospektiven Projekten planst du die Fallzahl möglichst früh und prüfst, ob sie mit deinen Ressourcen machbar ist. Bei retrospektiven Arbeiten steht die Zahl der Fälle meist fest. Eine nachträgliche Power auf Basis des beobachteten Effekts hilft dann kaum. Besser: die erreichbare Präzision der Schätzungen untersuchen und Grenzen offen benennen. Unterstützung bei der statistischen Doktorarbeit Medizin kann sowohl neue Studien als auch vorhandene Datensätze betreffen.
Die sieben häufigsten Fehler
- Fallzahl ohne klaren primären Endpunkt berechnen.
- Effektgröße willkürlich wählen, etwa pauschal "mittlerer Effekt".
- Ein ungeeignetes Verfahren verwenden.
- Die Streuung unterschätzen.
- Dropouts unzureichend berücksichtigen.
- Annahmen so lange drehen, bis die Wunschzahl passt.
- Die Planung erst nach der Datenerhebung erstellen.
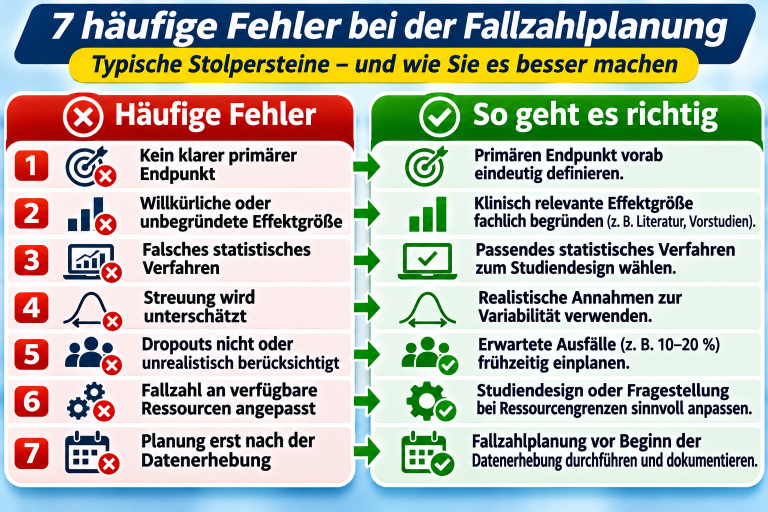
Sieben häufige Fehler bei der Fallzahlplanung klinischer Studien und wie man sie vermeidet.
Wenn die Fallzahl nicht erreichbar ist
Prüfe zuerst, ob sich das Design effizienter gestalten lässt: Ausgangsvariablen in der Analyse berücksichtigen, genauere Messverfahren nutzen, länger rekrutieren oder multizentrisch arbeiten. Solche Anpassungen müssen medizinisch und methodisch vertretbar sein. Ist eine ausreichend gepowerte Studie nicht machbar, kann eine explorative oder präzisionsorientierte Studie sinnvoll sein, mit angepasster Zielsetzung.
Bei komplexen Designs oder unsicheren Annahmen lohnt sich Beratung vor der Datenerhebung. Im Rahmen der Medizinischen Statistik lassen sich Fragestellung, Endpunkte, Analyseplan und Fallzahl gemeinsam abstimmen.
Fazit: Erst planen, dann erheben
Eine gute Fallzahlplanung beginnt nicht mit der Software, sondern mit einer präzisen Forschungsfrage, einem klar definierten Endpunkt und einem begründeten, klinisch relevanten Effekt. Danach folgen Power, Streuung, Design und Dropouts. Wichtig ist, dass die Herleitung transparent und zum Auswertungsverfahren passend ist.
Dein nächster Schritt: Prüfe heute anhand dieser Checkliste, ob Forschungsfrage, primärer Endpunkt, Studiendesign und primärer statistischer Vergleich eindeutig festgelegt sind. Erst dann rechne.
Wie viele Teilnehmende brauche ich pro Gruppe?
Das hängt von Effekt, Streuung, Power und Design ab. Im Beispiel mit Unterschied 5, Standardabweichung 10, α = 0,05 und 80 Prozent Power sind es rund 64 auswertbare Personen pro Gruppe, plus Aufschlag für Ausfälle.
Reicht eine Power von 80 Prozent?
Sie ist verbreitet, aber nicht immer ausreichend. Manche Studien streben 90 Prozent an. Beachte, dass höhere Power meist eine größere Stichprobe erfordert.
Reicht G*Power für meine Studie?
Für Standarddesigns oft ja. Bei Clusterdesigns, gemischten Modellen, komplexen Überlebenszeitanalysen oder adaptiven Designs brauchst du meist spezialisierte Verfahren oder Simulationen.
Kann ich die Fallzahl nachträglich berechnen?
Eine nachträgliche Berechnung ersetzt keine prospektive Planung. Bei vorhandenen Daten ist es sinnvoller, die erreichbare Präzision der Schätzungen darzustellen und Grenzen transparent zu machen.
Warum reicht ein pauschaler Dropout-Aufschlag nicht immer?
Abbrüche und fehlende Werte wirken unterschiedlich. Systematisch fehlende Daten verzerren Ergebnisse, und eine größere Stichprobe löst das nicht. Plane Szenarien und passe sie an das Analyseverfahren an.